
El Auge de los Modelos de Visión y Lenguaje en la Seguridad Pública y las Fuerzas del Orden
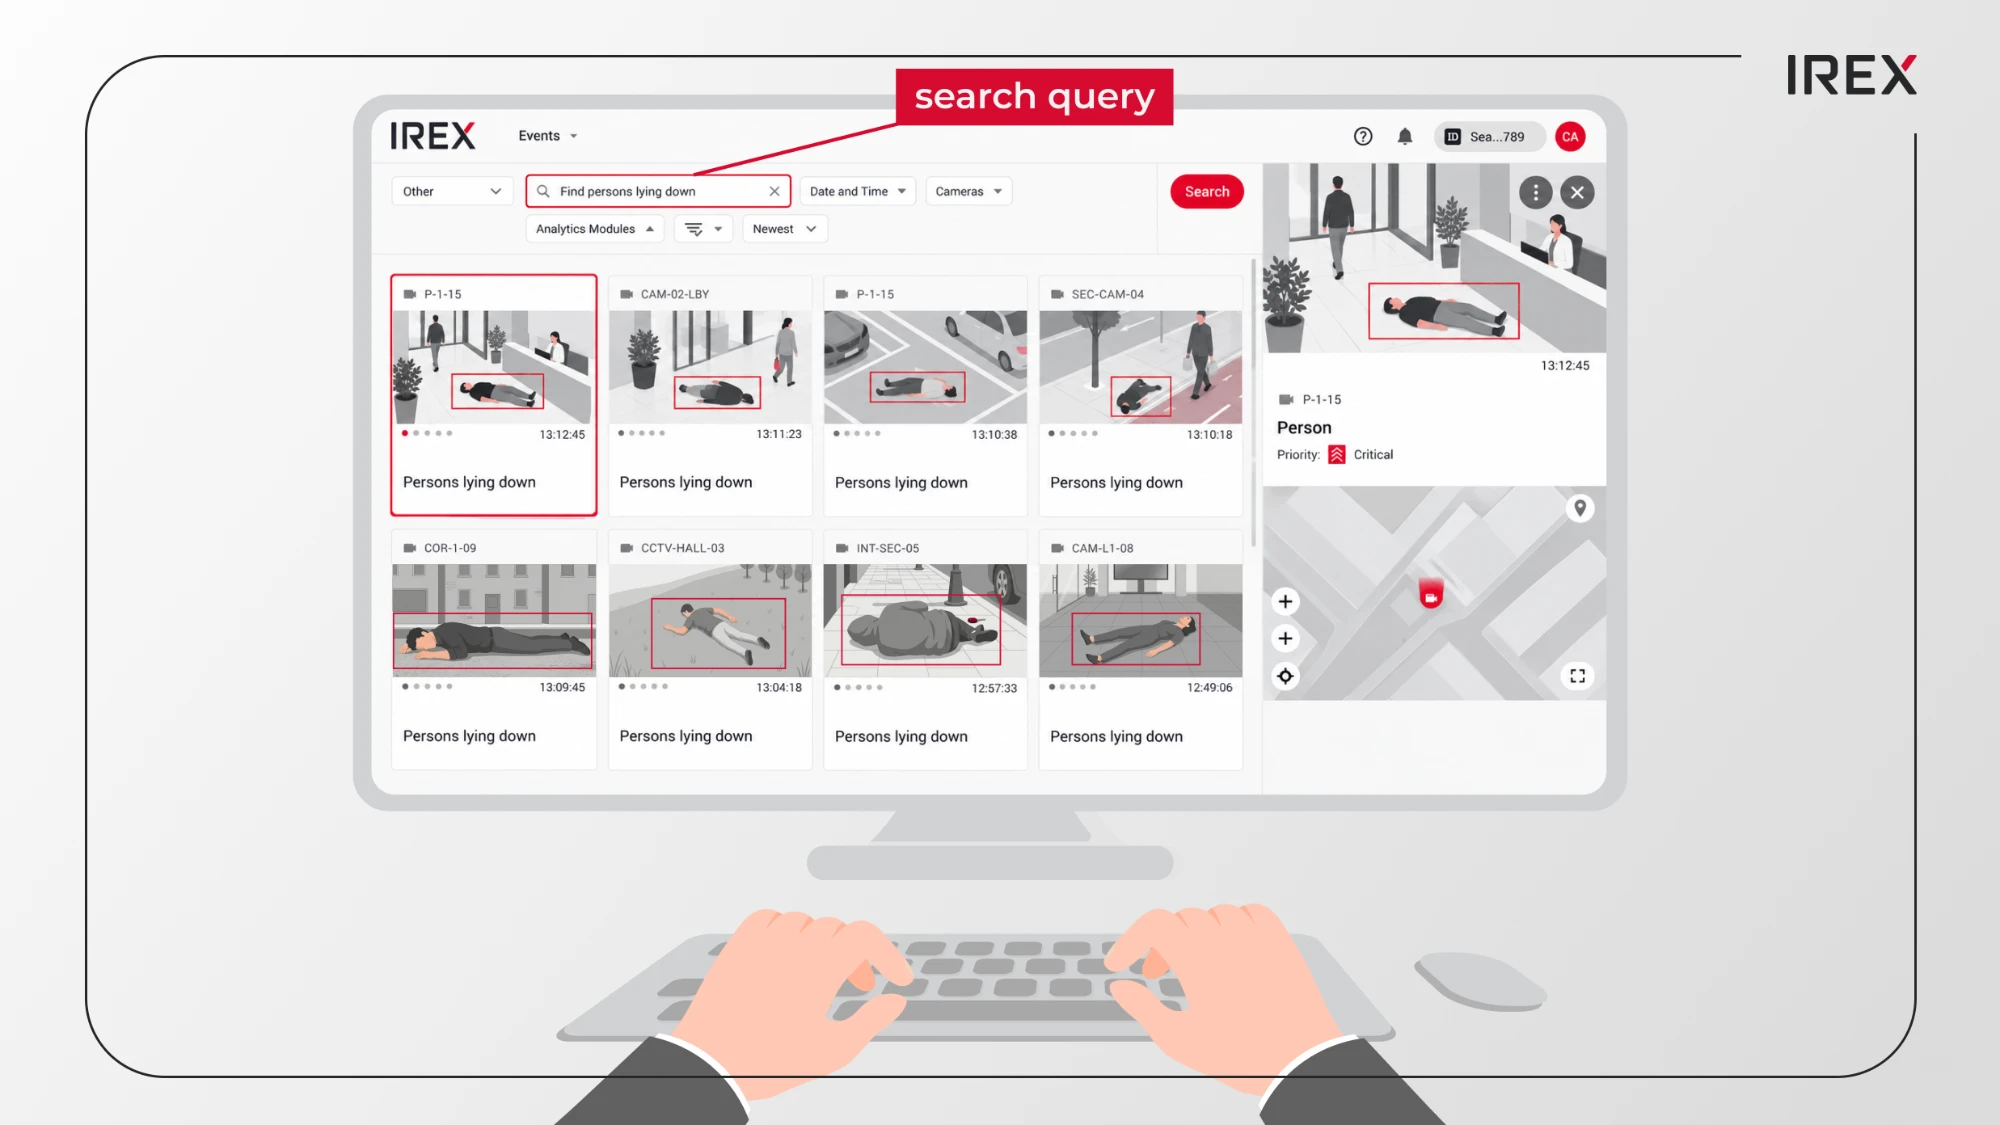
Tradicionalmente, la analítica de video se ha basado en modelos limitados y específicos para cada tarea: personas, vehículos, placas, humo, intrusiones y otras condiciones similares de alto volumen. Estos modelos se entrenan con datos etiquetados y se optimizan para una detección repetible, lo que exige mucho tiempo y esfuerzo.
Un modelo de visión y lenguaje, o VLM, es un tipo de IA multimodal que conecta la información visual con el lenguaje natural. Puede observar una imagen o un fotograma de video y responder a una pregunta o instrucción escrita. En la analítica de video, esto significa que un operador podría describir una condición: “emitir una alerta cuando haya escombros bloqueando el carril monitoreado”, y hacer que el sistema la busque en las cámaras seleccionadas, sin crear un conjunto de datos ni un modelo específicos.
De los detectores entrenados a las descripciones
La analítica de video tradicional destaca en tareas repetibles y de alto volumen. Detectar una persona, un vehículo, un rostro en un contexto de control de acceso o una placa exige precisión, velocidad y un rendimiento constante. Estos sistemas suelen entrenarse con grandes conjuntos de datos etiquetados y optimizarse para una sola tarea.
Un VLM es un modelo multimodal que conecta la entrada visual con el lenguaje. En lugar de devolver solo una etiqueta de clase como “persona” o “vehículo”, utiliza conocimientos visuales y lingüísticos generales para evaluar si una escena coincide con una descripción. El modelo puede abordar una tarea para la que no fue entrenado específicamente, guiado por la instrucción de texto y no por un nuevo conjunto de datos.
Esto resulta útil para condiciones fáciles de enunciar, pero difíciles de codificar como una regla fija. Un almacén puede necesitar detectar salidas de emergencia bloqueadas. A una autoridad de transporte le pueden interesar los escombros en una vía. Una ciudad puede querer identificar vertidos ilegales, grafitis o inundaciones. Aunque estas tareas son importantes para el uso de VLM por parte de las fuerzas del orden, puede que no justifiquen lo suficiente el desarrollo y el mantenimiento de un modelo específico para cada sitio.
Los detectores tradicionales siguen siendo preferibles para el seguimiento a alta velocidad y para objetos definidos de forma consistente. En la analítica de video, los VLM se adaptan mejor a condiciones de menor frecuencia y dependientes del contexto, en las que el valor operativo está en que la escena coincida con una descripción y no en seguir un objeto de un fotograma a otro.
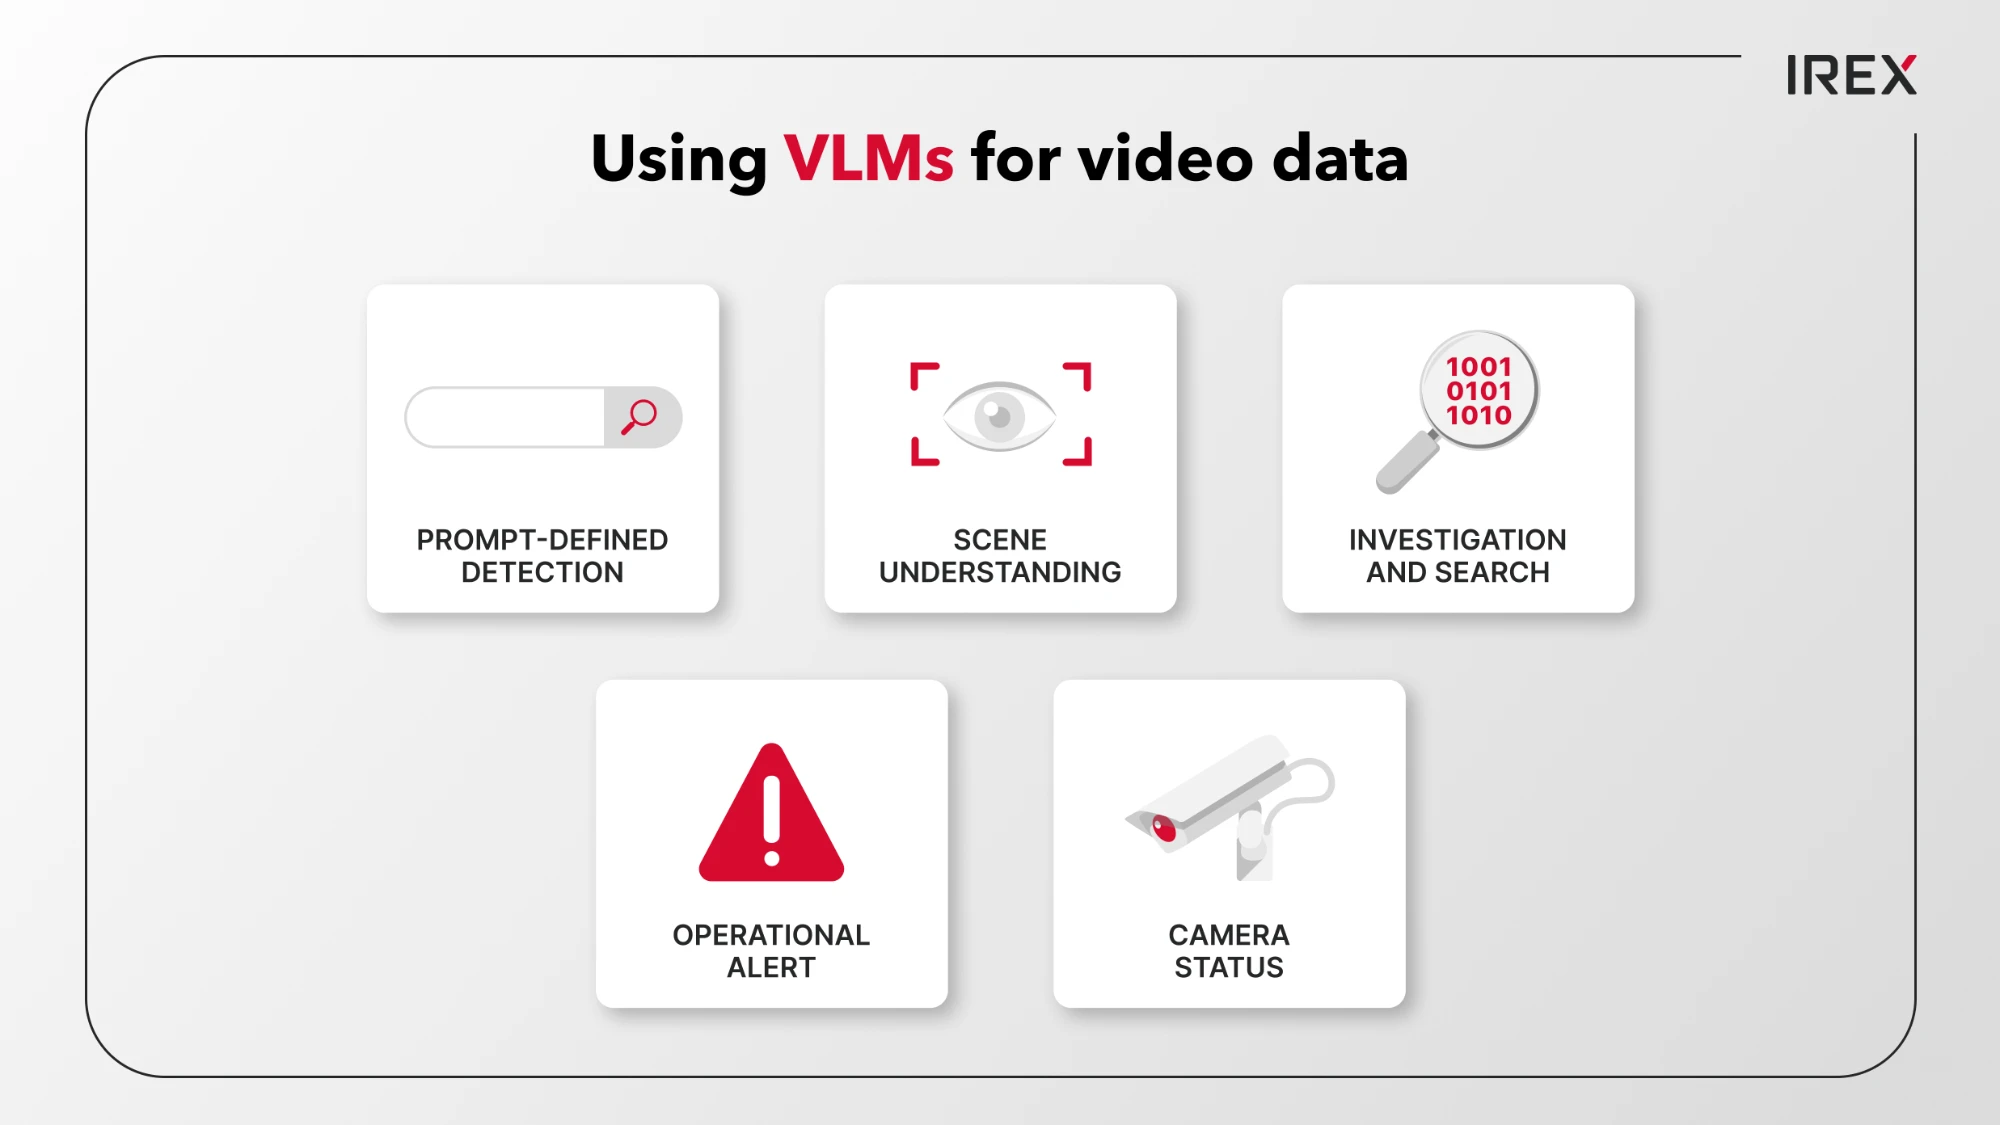
Uso de VLM con datos de video en la seguridad pública y las fuerzas del orden
En la práctica, los VLM pueden apoyar varias partes de un flujo de trabajo de video:
- Detección definida mediante instrucciones: convertir una condición escrita en un detector para las cámaras seleccionadas.
- Comprensión de escenas: reconocer relaciones y contexto, como una persona cerca de un área restringida o un vehículo detenido donde no debería estar.
- Investigación y búsqueda: aplicar una consulta descriptiva a las grabaciones, no solo al video en vivo.
- Alertas operativas: generar un evento cuando aparece una condición descrita y después canalizarlo hacia los procesos existentes de alerta y revisión.
- Estado de las cámaras: identificar vistas de cámara obstruidas, degradadas o desalineadas.
Lo importante es que un VLM no se limita a etiquetar objetos. Evalúa si la escena se ajusta al significado de la instrucción. Eso lo hace útil para condiciones que a las personas les resulta fácil describir, pero que son difíciles de definir con una regla fija.
Alcance y limitaciones
Los VLM para la seguridad pública y las fuerzas del orden no sustituyen a todos los modelos de analítica. Pueden malinterpretar el contexto, pasar por alto eventos rápidos o dar con total seguridad una respuesta incorrecta, un problema que suele denominarse alucinación. En la seguridad pública, una falsa alerta desperdicia la atención del operador. Un evento no detectado puede tener consecuencias más graves.
El rendimiento de un VLM depende de la ubicación de la cámara, la iluminación, las oclusiones, la redacción de la instrucción, los umbrales de confianza y los intervalos entre alertas. Un detector debe probarse con escenas habituales que puedan parecerse a las condiciones buscadas y validarse con grabaciones representativas.
Por eso, el diseño del despliegue importa tanto como la capacidad del modelo. Un sistema responsable necesita umbrales de confianza, intervalos entre alertas, delimitación de las cámaras, registros de auditoría y revisión humana. El VLM debe emitir una señal, no tomar una decisión. Los operadores siguen necesitando el contexto, la autoridad y la responsabilidad para verificar lo ocurrido y decidir qué hacer a continuación.
También hay que respetar un límite de privacidad. Una instrucción que describe una escena o una condición no debe convertirse en una forma de identificar o rastrear a personas concretas. En una plataforma de seguridad pública, la analítica de video con VLM debe estar separada de las funciones de identificación y regirse por los mismos controles de acceso y requisitos de auditoría que el resto de la analítica.
Dónde encaja IREX
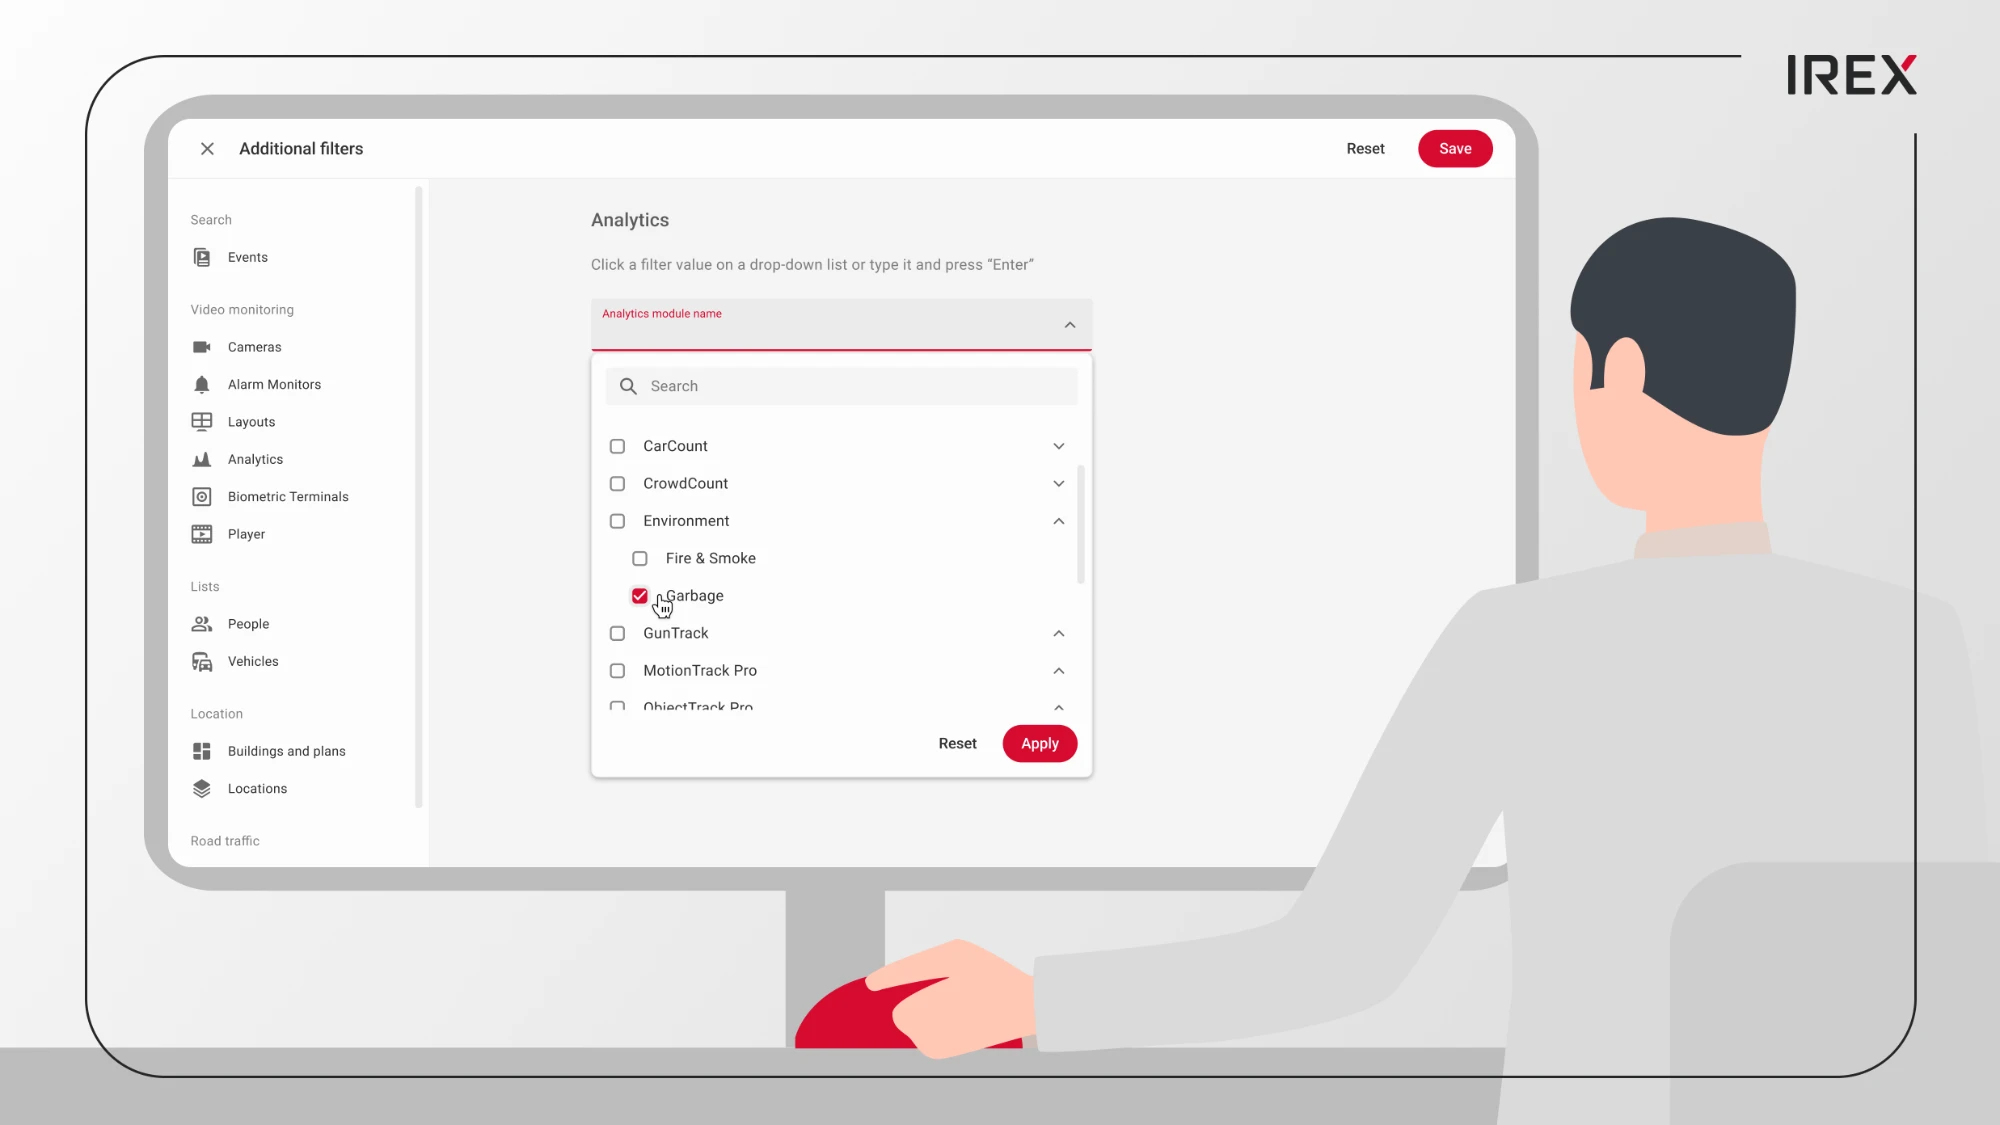
IREX aplica este enfoque mediante StreamVLM™, una función que convierte una instrucción en lenguaje natural en un detector de video operativo. Los operadores pueden crear condiciones como “persona caída”, “vertido ilegal” o “vehículo en un área restringida”, asignarlas a cámaras y recibir eventos a través de los flujos de trabajo de alertas, búsqueda e investigación que IREX ya tiene.
Muchos proveedores están explorando modelos multimodales, pero la diferencia está en el lugar que ocupa el VLM dentro del flujo de trabajo operativo y en las salvaguardas que existen. En IREX, los eventos de StreamVLM utilizan el mismo marco de gobernanza que la analítica entrenada: acceso basado en roles, registro de instrucciones y eventos, inferencia local dentro de la instancia del cliente y revisión humana antes de cualquier respuesta.
IREX StreamVLM™ amplía una plataforma de video para la seguridad pública con detectores definidos mediante instrucciones: describa una condición específica del sitio, despliéguela en las cámaras seleccionadas y conviértala en un evento auditable en tiempo real.