
A Ascensão dos Modelos de Visão e Linguagem na Segurança Pública e nas Forças Policiais
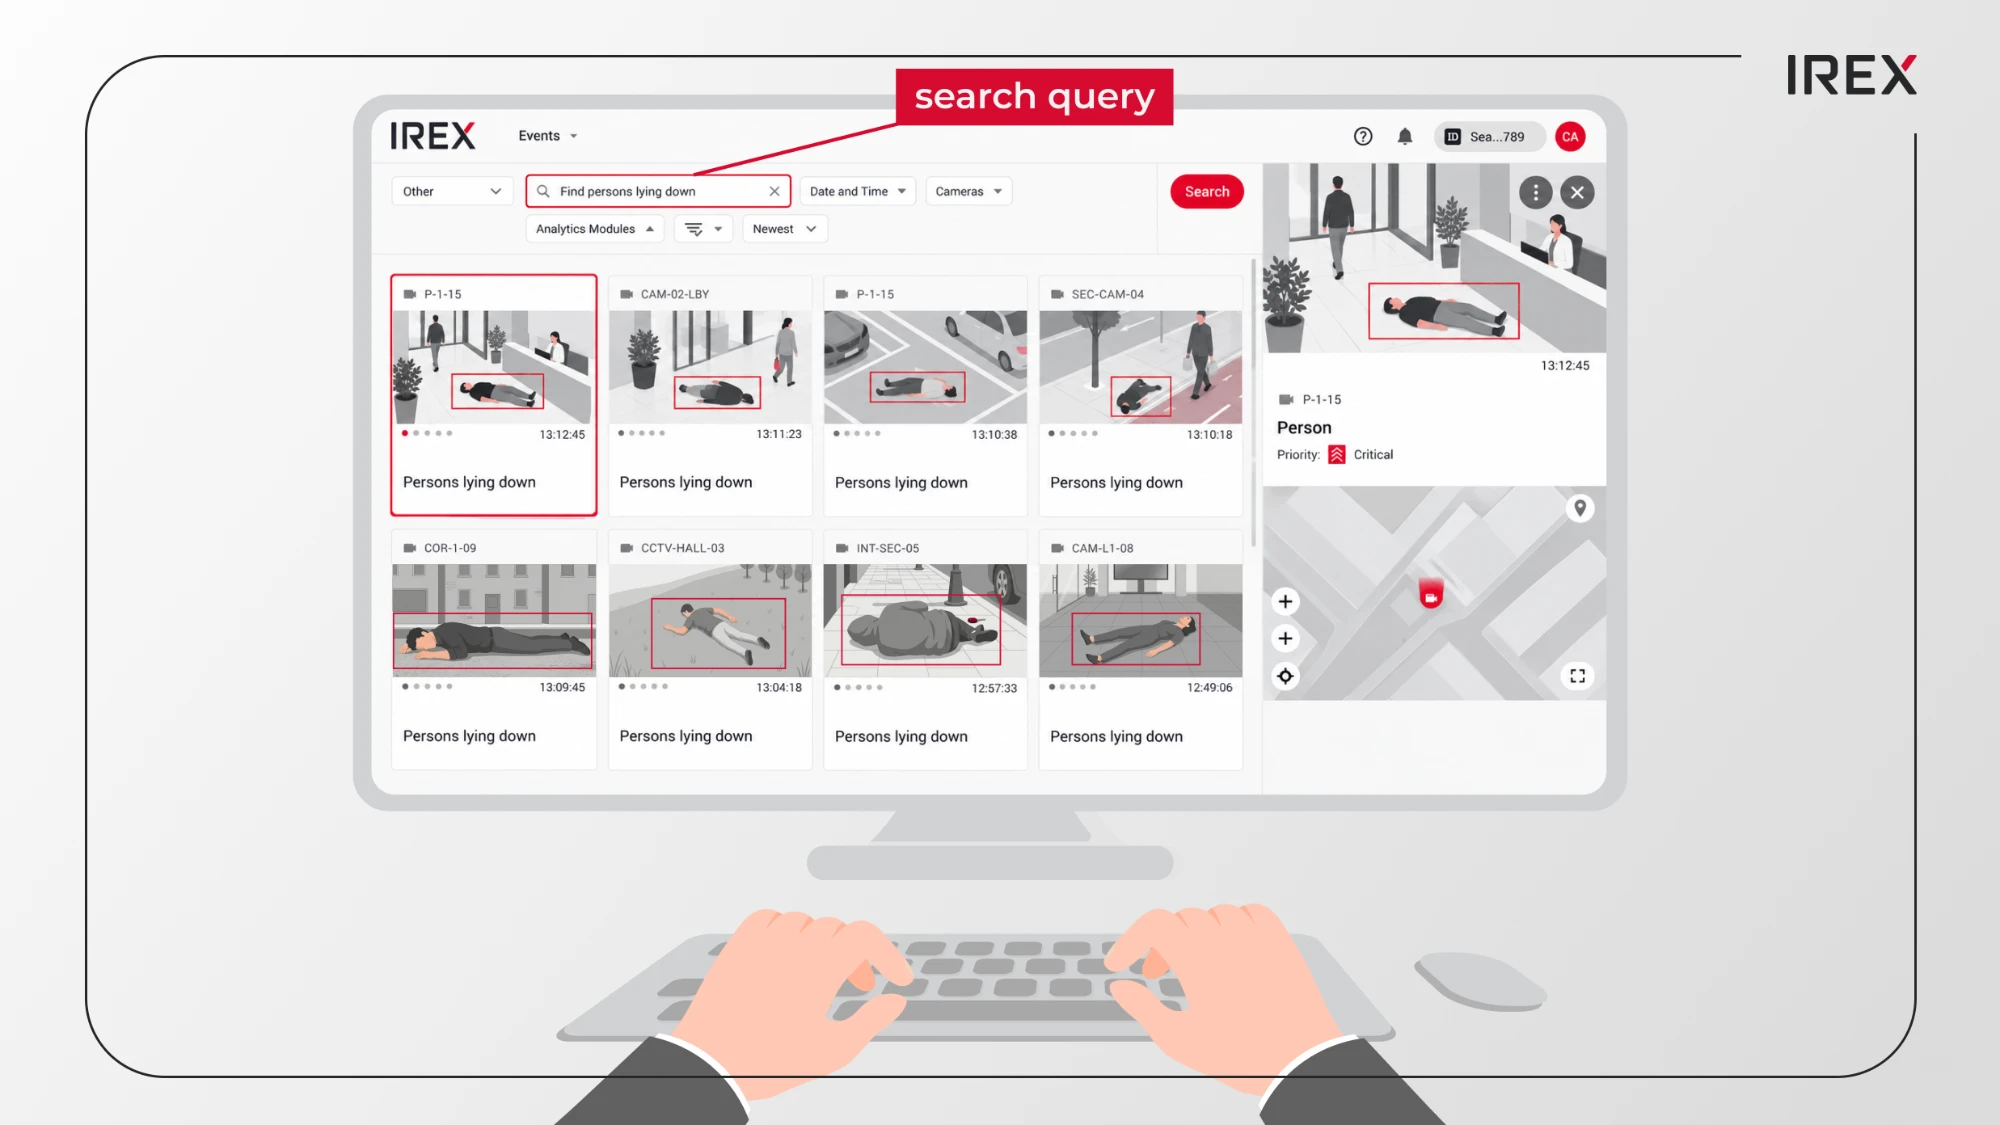
A análise de vídeo tradicionalmente depende de modelos limitados e específicos para cada tarefa: pessoas, veículos, placas, fumaça, intrusão e outras situações semelhantes de alto volume. Esses modelos são treinados com dados rotulados e otimizados para uma detecção repetível, o que exige muito tempo e esforço.
Um modelo de visão e linguagem, ou VLM, é um tipo de IA multimodal que relaciona informações visuais com linguagem natural. Ele pode analisar uma imagem ou um quadro de vídeo e responder a uma pergunta ou instrução escrita. Na análise de vídeo, isso significa que um operador pode descrever uma situação, como “alertar quando detritos bloquearem a faixa monitorada”, e fazer com que o sistema a procure nas câmeras selecionadas, sem criar um conjunto de dados ou modelo dedicado.
De detectores treinados a descrições
A análise de vídeo tradicional é excelente em tarefas repetíveis e de alto volume. Detectar uma pessoa, um veículo, um rosto em um contexto de controle de acesso ou uma placa exige precisão, velocidade e desempenho consistente. Esses sistemas geralmente são treinados com grandes conjuntos de dados rotulados e otimizados para uma única função.
Um VLM é um modelo multimodal que relaciona a entrada visual com a linguagem. Em vez de retornar apenas um rótulo de classe, como “pessoa” ou “veículo”, ele usa conhecimento visual e linguístico geral para avaliar se uma cena corresponde a uma descrição. O modelo pode executar uma tarefa para a qual não foi especificamente treinado, orientado pela instrução em texto, e não por um novo conjunto de dados.
Isso é útil para situações fáceis de descrever, mas difíceis de codificar como uma regra fixa. Um armazém pode precisar identificar saídas de emergência bloqueadas. Uma autoridade de transporte pode se preocupar com detritos na via. Uma cidade pode querer identificar descarte irregular de lixo, grafites ou inundações. Embora essas tarefas sejam relevantes para o uso de VLMs pelas forças policiais, elas podem não justificar o suficiente o desenvolvimento e a manutenção de um modelo específico para cada local.
Os detectores tradicionais continuam sendo preferíveis para o rastreamento em alta velocidade e para objetos definidos de forma consistente. Na análise de vídeo, os VLMs são mais adequados para situações menos frequentes e dependentes de contexto, em que o valor operacional está em corresponder a uma descrição, e não em rastrear um objeto ao longo dos quadros.
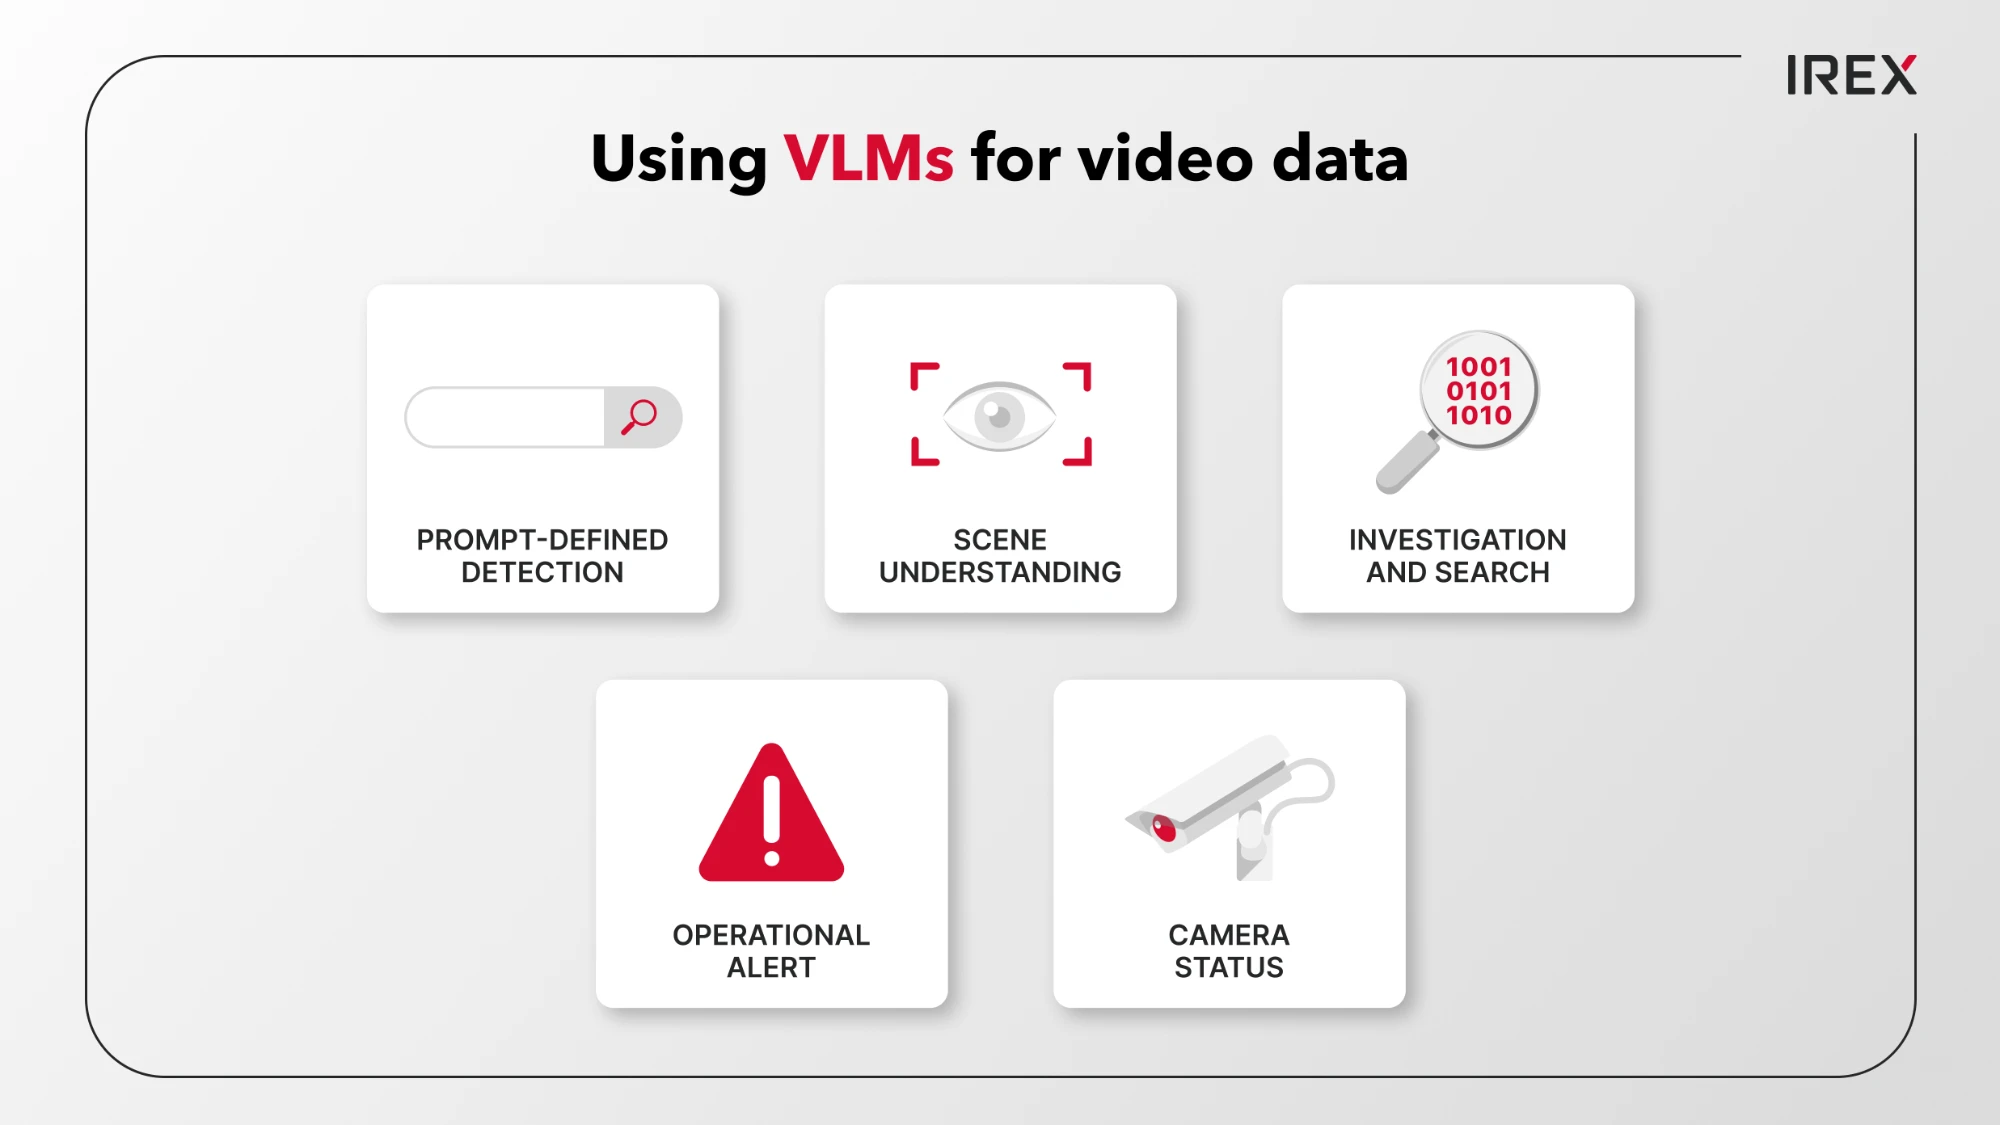
Uso de VLMs com dados de vídeo na segurança pública e nas forças policiais
Na prática, os VLMs podem apoiar várias etapas de um fluxo de trabalho com vídeo:
- Detecção definida por instruções: transformar uma condição escrita em um detector para as câmeras selecionadas.
- Compreensão de cena: reconhecer relações e contexto, como uma pessoa perto de uma área restrita ou um veículo parado onde não deveria estar.
- Investigação e busca: aplicar uma consulta descritiva a gravações, e não apenas ao vídeo ao vivo.
- Alertas operacionais: gerar um evento quando uma situação descrita aparece e encaminhá-lo aos processos existentes de alerta e revisão.
- Status da câmera: identificar visões de câmera obstruídas, degradadas ou desalinhadas.
O ponto importante é que um VLM não se limita a rotular objetos. Ele avalia se a cena corresponde ao significado da instrução. Isso o torna útil para situações fáceis de descrever para as pessoas, mas difíceis de definir com uma regra fixa.
Limites e restrições
Os VLMs para segurança pública e forças policiais não substituem todos os modelos de análise. Eles podem interpretar mal o contexto, deixar de captar eventos rápidos ou produzir com confiança uma resposta errada, um problema comumente chamado de alucinação. Na segurança pública, um alerta falso desperdiça a atenção do operador. Um evento não detectado pode ter consequências mais graves.
O desempenho de um VLM depende do posicionamento da câmera, da iluminação, da oclusão, da redação da instrução, dos limiares de confiança e dos intervalos entre alertas. Um detector deve ser testado em cenas comuns que possam se parecer com as situações-alvo e validado com imagens representativas.
É por isso que o design da implantação importa tanto quanto a capacidade do modelo. Um sistema responsável precisa de limiares de confiança, intervalos entre alertas, definição do escopo de câmeras, registros de auditoria e revisão humana. O VLM deve emitir um sinal, não tomar uma decisão. Os operadores continuam precisando do contexto, da autoridade e da responsabilidade para verificar o que aconteceu e decidir o que fazer em seguida.
Também há um limite de privacidade a ser mantido. Uma instrução que descreve uma cena ou situação não deve se tornar uma forma de identificar ou rastrear indivíduos. Em uma plataforma de segurança pública, a análise de vídeo com VLM deve ser separada das funções de identificação e regida pelos mesmos controles de acesso e requisitos de auditoria das demais análises.
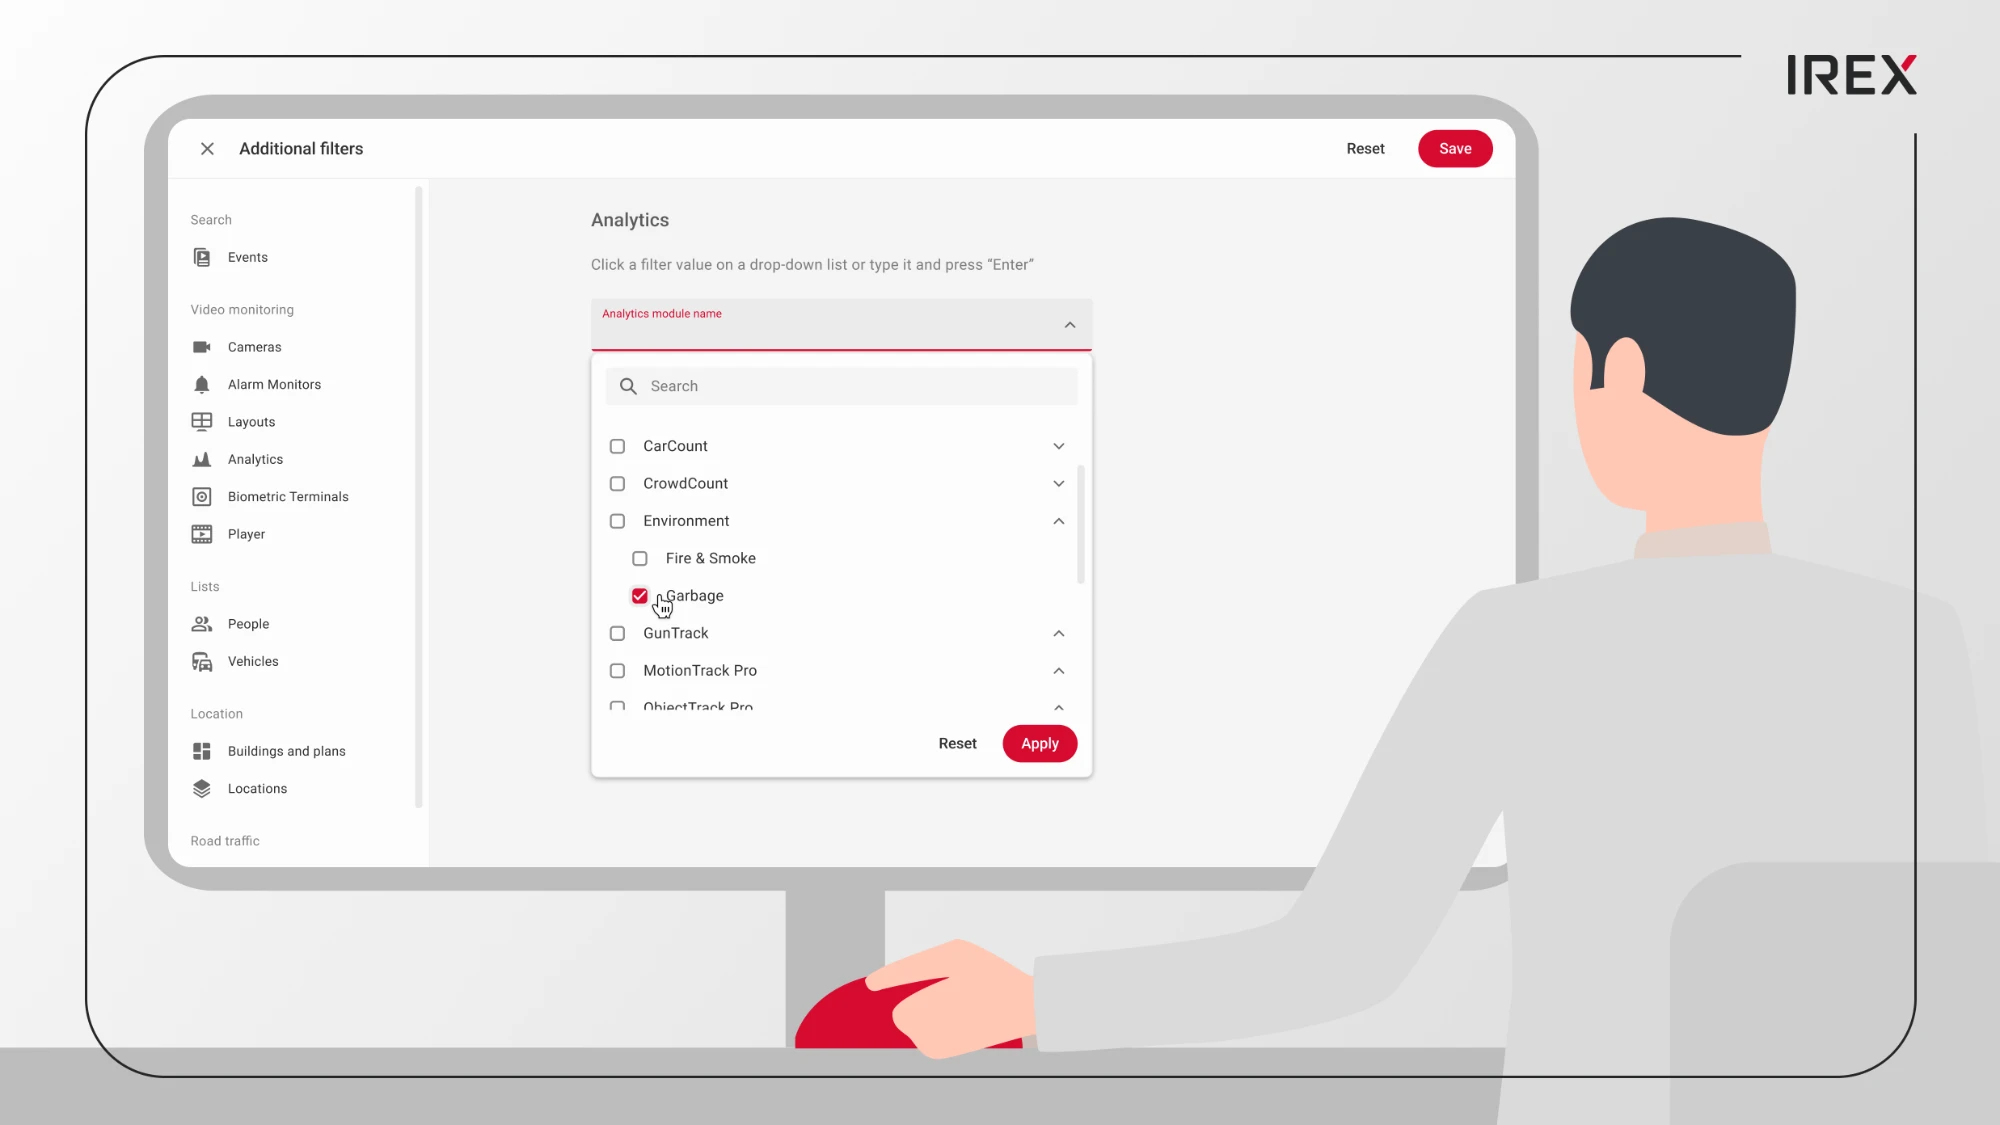
O papel da IREX
A IREX aplica essa abordagem por meio do StreamVLM™, um recurso que transforma uma instrução em linguagem natural em um detector de vídeo funcional. Os operadores podem criar condições como “pessoa caída”, “descarte irregular de lixo” ou “veículo em área restrita”, atribuí-las às câmeras e receber eventos pelos fluxos de trabalho de alertas, busca e investigação que a IREX já oferece.
Muitos fornecedores estão explorando modelos multimodais, mas a diferença está na posição do VLM no fluxo de trabalho operacional e nas salvaguardas existentes. Na IREX, os eventos do StreamVLM seguem o mesmo modelo de governança das análises treinadas: acesso baseado em papéis, registro de instruções e eventos, inferência local na instância do cliente e revisão humana antes de qualquer resposta.
O IREX StreamVLM™ amplia uma plataforma de vídeo para segurança pública com detectores definidos por instruções: descreva uma condição específica do local, implante-a nas câmeras selecionadas e transforme-a em um evento auditável em tempo real.