
صعود نماذج الرؤية واللغة في السلامة العامة وإنفاذ القانون
اعتمدت تحليلات الفيديو تقليديًا على نماذج ضيقة النطاق مخصّصة لمهام بعينها: الأشخاص والمركبات ولوحات أرقام المركبات والدخان والتسلّل وما شابهها من الحالات عالية التكرار. وتُدرَّب هذه النماذج على بيانات موسومة وتُحسَّن لتحقيق كشف قابل للتكرار، وهو ما يتطلب الكثير من الوقت والجهد.
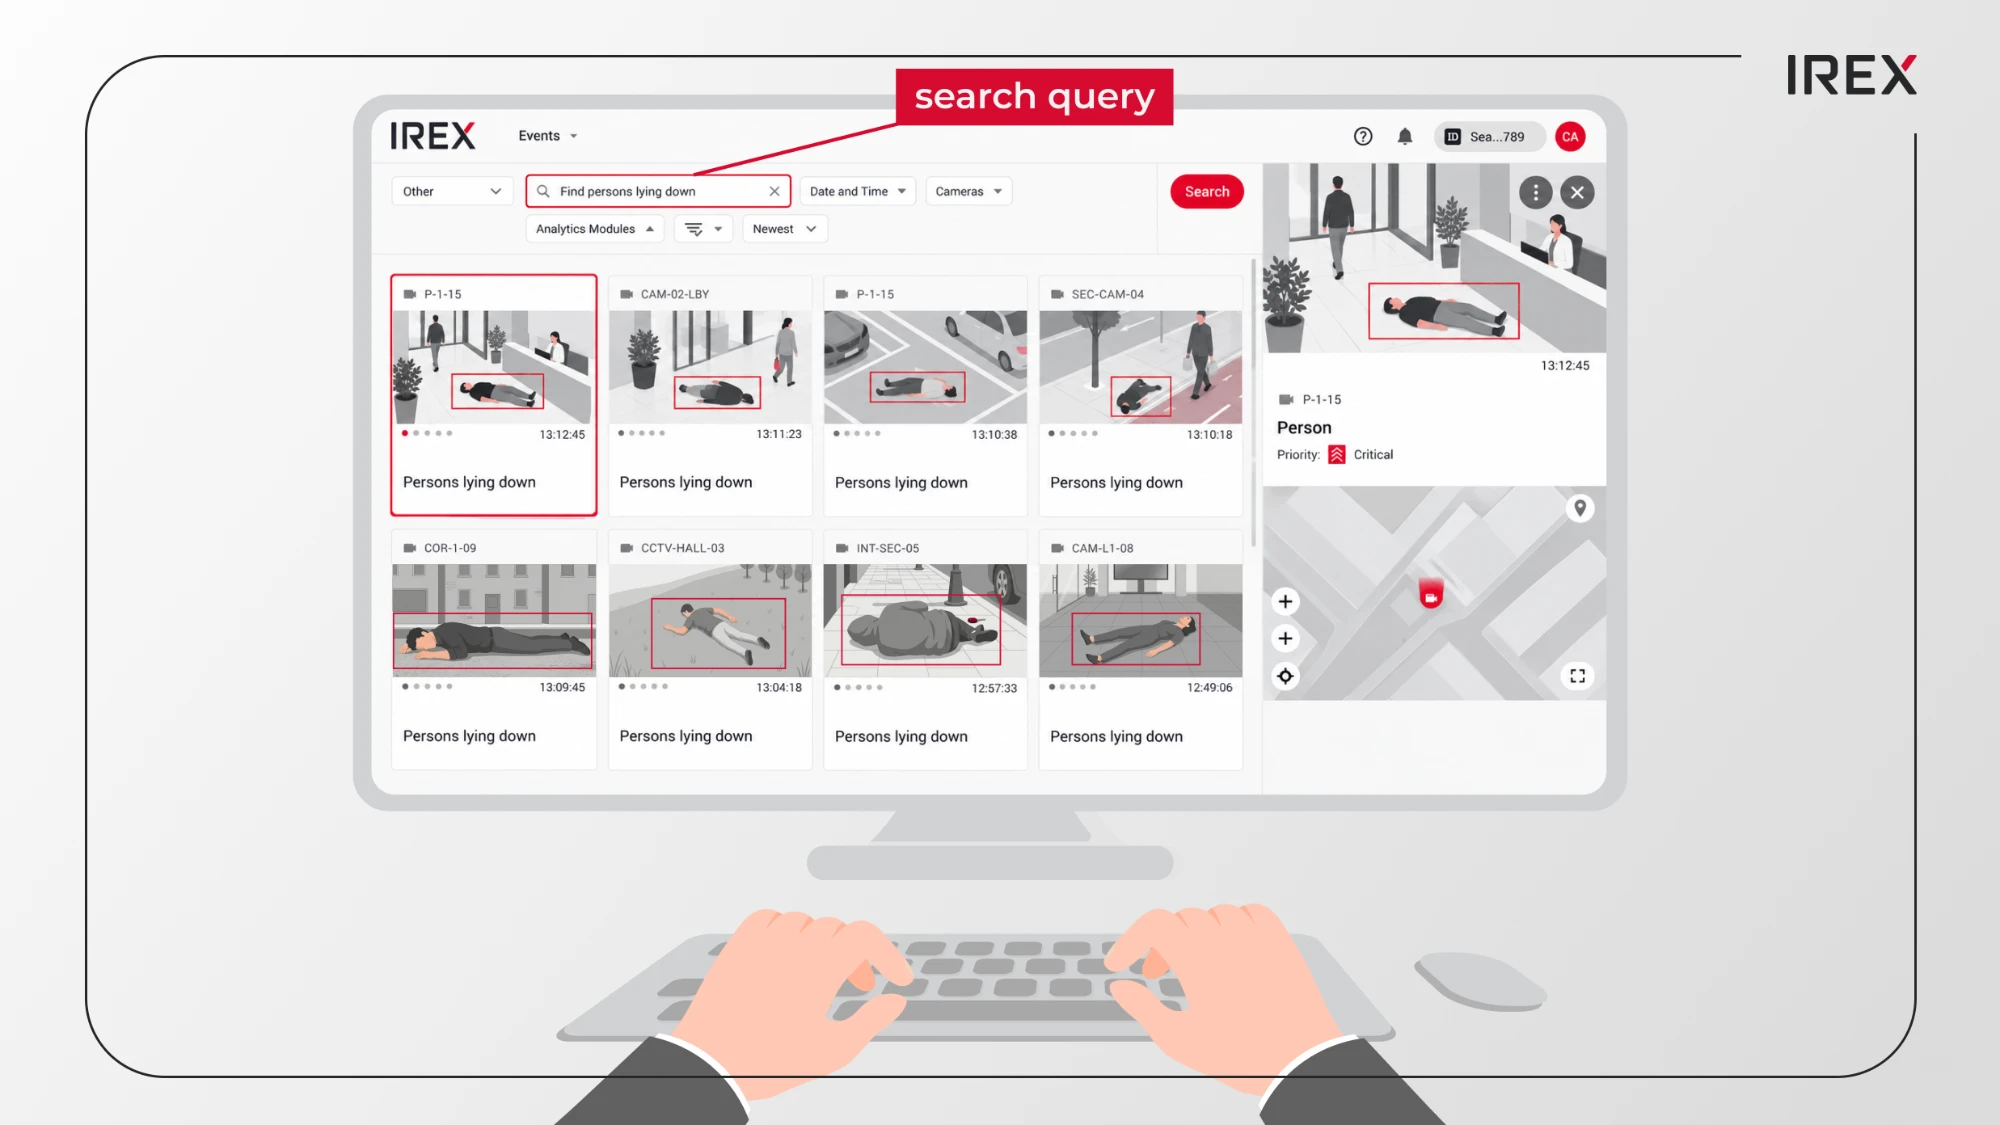
نموذج الرؤية واللغة، أو VLM، هو نوع من الذكاء الاصطناعي متعدد الوسائط يربط المعلومات البصرية باللغة الطبيعية. إذ يمكنه النظر إلى صورة أو إطار فيديو والاستجابة لسؤال أو تعليمات مكتوبة. وفي تحليلات الفيديو، يعني ذلك أن المشغّل قد يتمكّن من وصف حالة ما، مثل: «نبّه عندما يسدّ حطامٌ المسارَ المراقَب»، ليبحث عنها النظام عبر الكاميرات المحددة، دون بناء مجموعة بيانات أو نموذج مخصّص.
من الكواشف المدرَّبة إلى الأوصاف
تتفوّق تحليلات الفيديو التقليدية في المهام المتكررة عالية الحجم. فكشف شخص أو مركبة أو وجه في سياق التحكم في الدخول أو لوحة أرقام مركبة يتطلب الدقة والسرعة والأداء المتّسق. وعادةً ما تُدرَّب هذه الأنظمة على مجموعات بيانات كبيرة موسومة وتُحسَّن لأداء مهمة واحدة.
نموذج الرؤية واللغة هو نموذج متعدد الوسائط يربط المدخلات البصرية باللغة. فبدلًا من الاكتفاء بإرجاع تصنيف فئة مثل «شخص» أو «مركبة»، يستخدم معرفة بصرية ولغوية عامة لتقييم ما إذا كان المشهد يطابق وصفًا معيّنًا. ويمكن للنموذج معالجة مهمة لم يُدرَّب عليها تحديدًا، مسترشدًا بالموجّه النصي بدلًا من مجموعة بيانات جديدة.
ويُعدّ ذلك مفيدًا للحالات التي يسهل التعبير عنها لكن يصعب ترميزها في قاعدة ثابتة. فقد يحتاج مستودع إلى رصد مخارج الطوارئ المسدودة. وقد تهتم هيئة نقل بوجود حطام على الطريق. وقد ترغب مدينة في رصد الإلقاء غير القانوني للنفايات أو الكتابة على الجدران أو الفيضانات. ومع أن هذه المهام مهمة لاستخدام نماذج الرؤية واللغة في إنفاذ القانون، فإنها قد لا تقدّم مبرّرًا كافيًا لتطوير نموذج خاص بموقع بعينه وصيانته.
وتظل الكواشف التقليدية الخيار الأفضل للتتبّع عالي السرعة وللأجسام المحدّدة على نحو ثابت. أما نماذج الرؤية واللغة في تحليلات الفيديو، فهي أنسب للحالات الأقل تكرارًا والمعتمدة على السياق، حيث تكمن القيمة التشغيلية في مطابقة وصف ما بدلًا من تتبّع جسم عبر الإطارات.
استخدام نماذج الرؤية واللغة لبيانات الفيديو في السلامة العامة وإنفاذ القانون
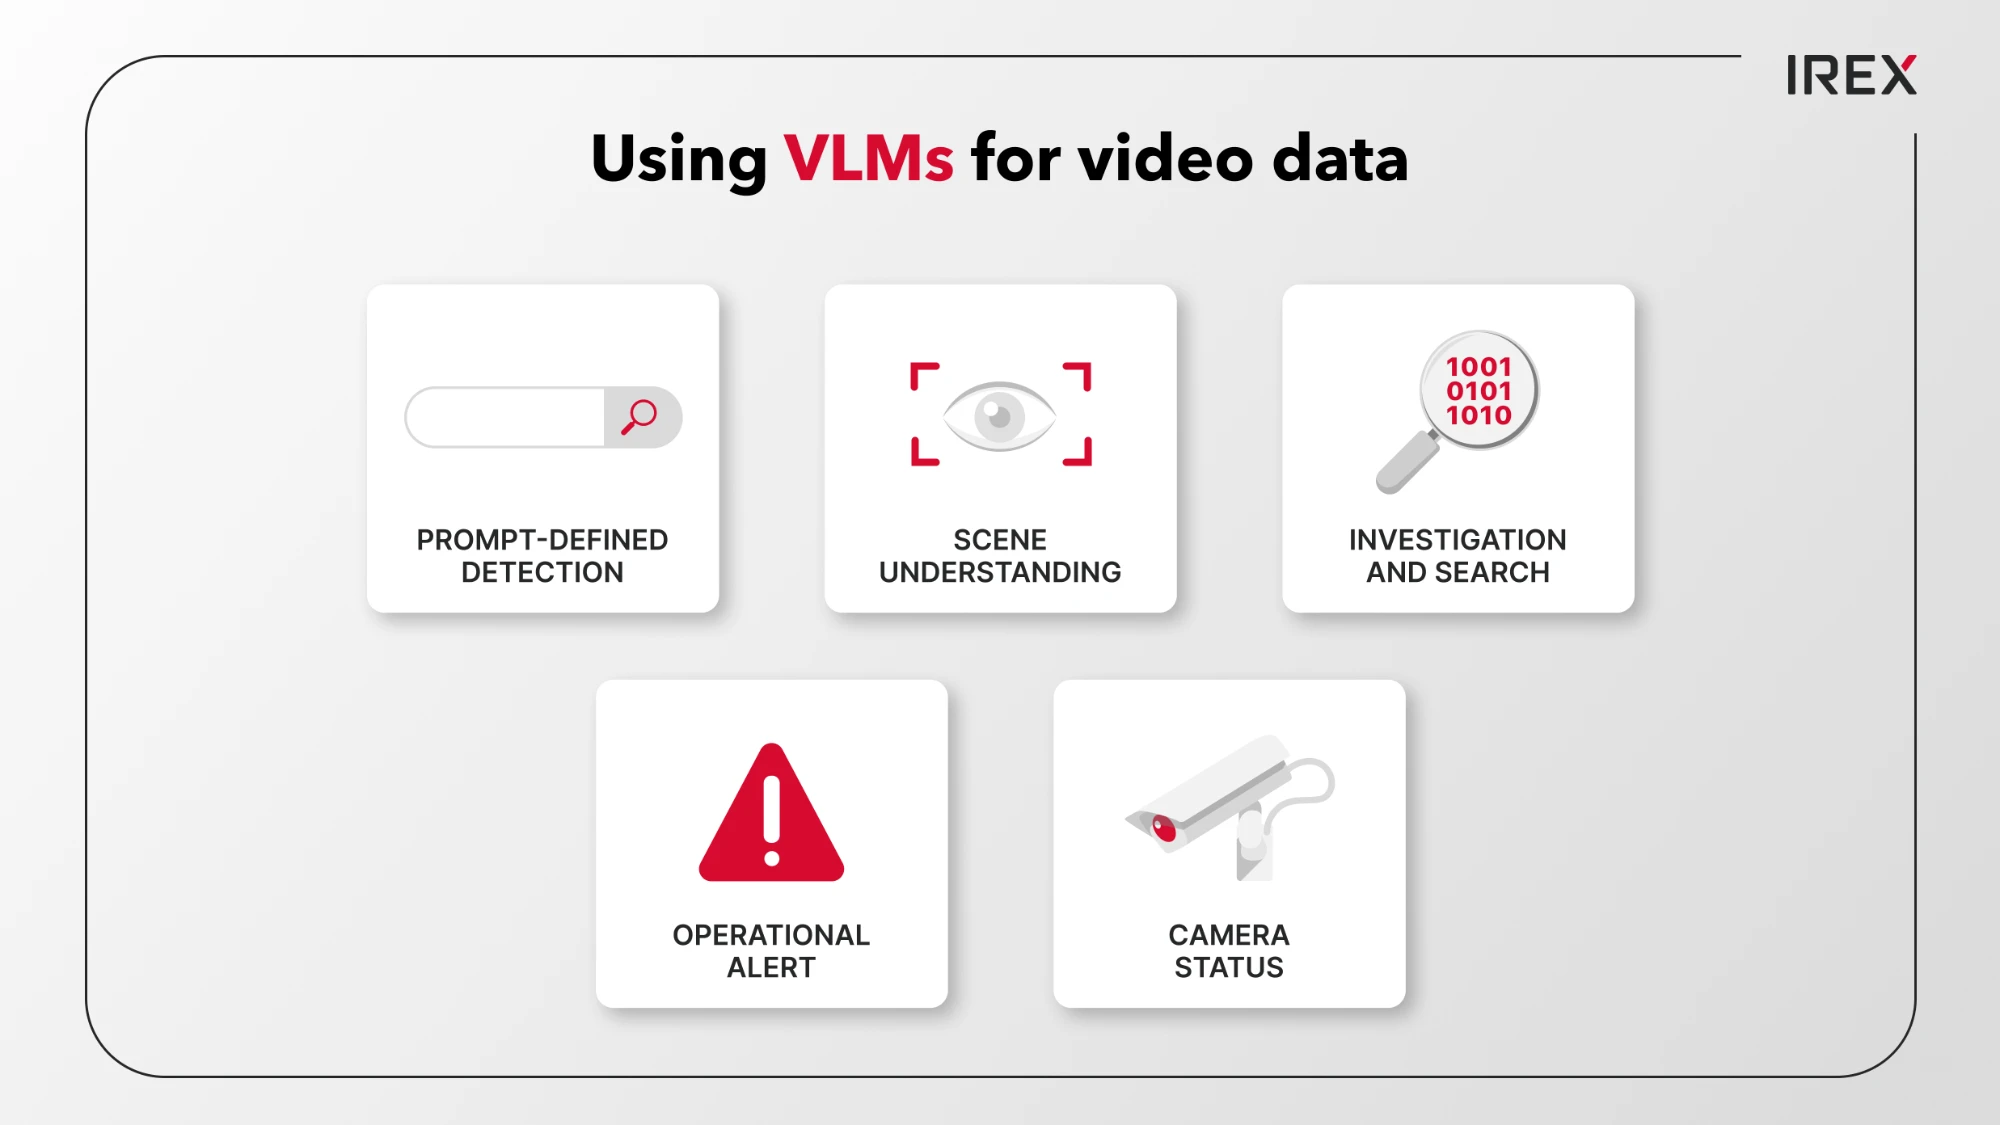
من الناحية العملية، يمكن لنماذج الرؤية واللغة أن تدعم عدة أجزاء من سير العمل المتعلق بالفيديو:
- الكشف المحدَّد بموجّه نصي: تحويل حالة مكتوبة إلى كاشف لكاميرات محددة.
- فهم المشهد: التعرّف على العلاقات والسياق، مثل وجود شخص قرب منطقة محظورة أو مركبة متوقفة في مكان لا ينبغي أن تتوقف فيه.
- التحقيق والبحث: تطبيق استعلام وصفي على اللقطات المسجّلة، لا على الفيديو المباشر فقط.
- التنبيهات التشغيلية: إنشاء حدث عند ظهور حالة موصوفة، ثم توجيهه إلى عمليات التنبيه والمراجعة القائمة.
- حالة الكاميرا: تحديد مشاهد الكاميرات المحجوبة أو المتدهورة الجودة أو المنحرفة عن موضعها.
والنقطة المهمة هي أن نموذج الرؤية واللغة لا يكتفي بتسمية الأجسام، بل يقيّم ما إذا كان المشهد يتوافق مع معنى الموجّه النصي. وهذا ما يجعله مفيدًا للحالات التي يسهل على الناس وصفها لكن يصعب تعريفها بقاعدة ثابتة.
الحدود والقيود
لا تُعدّ نماذج الرؤية واللغة المخصّصة للسلامة العامة وإنفاذ القانون بديلًا عن كل نموذج تحليلات. فقد تُسيء تفسير السياق، أو تفوّت الأحداث سريعة الحركة، أو تقدّم إجابة واثقة لكنها خاطئة - وهي مشكلة تُعرف عادةً بالهلوسة. وفي السلامة العامة، يهدر التنبيه الكاذب انتباه المشغّل. أما الحدث الذي يفوت رصده فقد تترتب عليه عواقب أخطر.
ويعتمد أداء نماذج الرؤية واللغة على موضع الكاميرا والإضاءة والحجب وصياغة الموجّه النصي وعتبات الثقة وفترات التهدئة بين التنبيهات. وينبغي اختبار أي كاشف على مشاهد اعتيادية قد تشبه الحالات المستهدفة، والتحقق من صحته على لقطات تمثيلية.
ولهذا يكتسب تصميم النشر أهمية لا تقل عن قدرات النموذج. فالنظام المسؤول يحتاج إلى عتبات ثقة، وفترات تهدئة بين التنبيهات، وتحديد نطاق الكاميرات، وسجلات تدقيق، ومراجعة بشرية. وينبغي أن يطلق نموذج الرؤية واللغة إشارة، لا أن يتخذ قرارًا. فلا يزال المشغّلون بحاجة إلى السياق والصلاحية والمسؤولية للتحقق مما حدث وتقرير الخطوة التالية.
وثمة أيضًا حدّ للخصوصية يجب الحفاظ عليه. فالموجّه النصي الذي يصف مشهدًا أو حالة لا ينبغي أن يتحوّل إلى وسيلة لتحديد هوية الأفراد أو تتبّعهم. وفي منصة للسلامة العامة، ينبغي فصل تحليلات الفيديو القائمة على نماذج الرؤية واللغة عن وظائف تحديد الهوية، وإخضاعها لضوابط الوصول ومتطلبات التدقيق نفسها التي تخضع لها التحليلات الأخرى.
موقع IREX في هذا المشهد
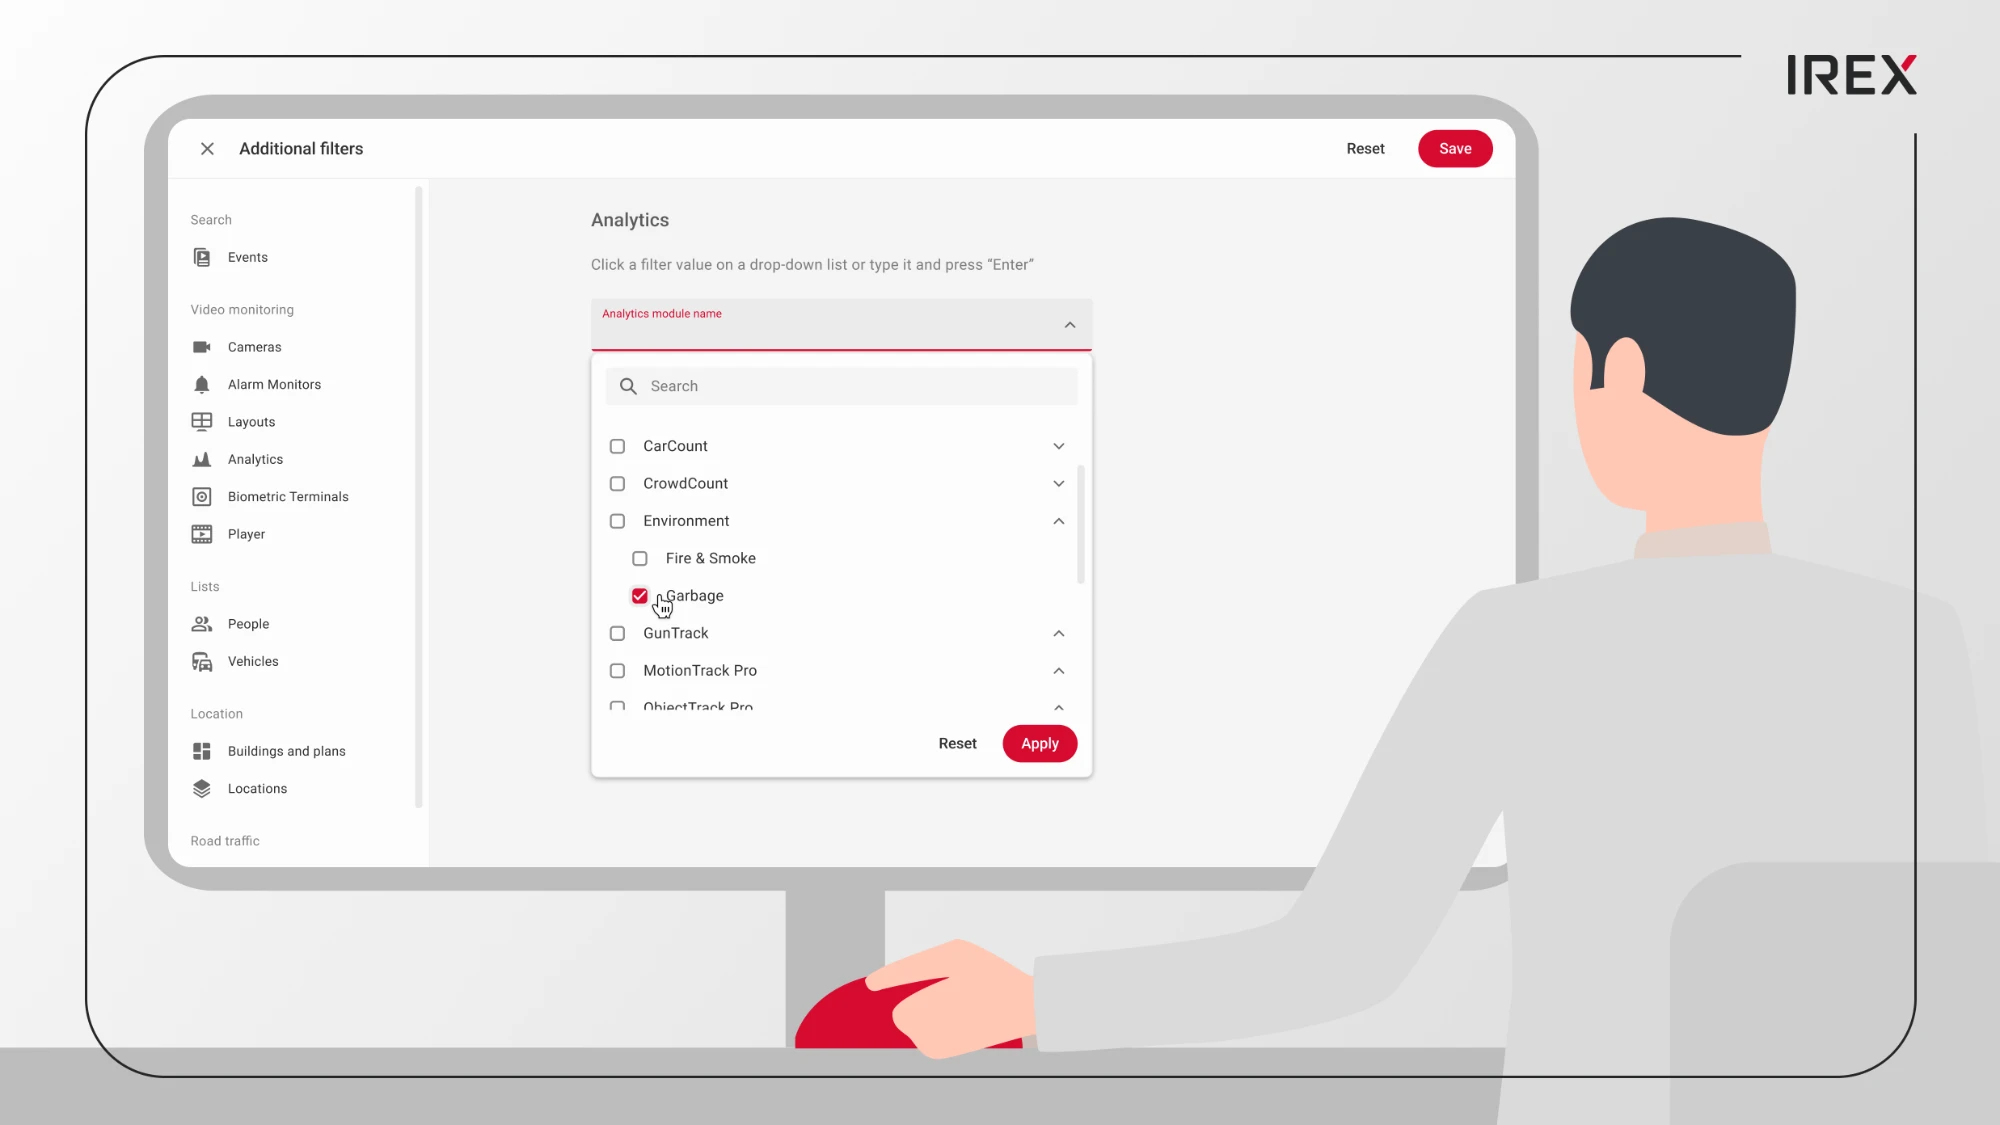
تطبّق IREX هذا النهج من خلال StreamVLM™، وهي ميزة تحوّل موجّهًا نصيًا بلغة بسيطة إلى كاشف فيديو فعّال. ويمكن للمشغّلين إنشاء حالات مثل «شخص ساقط» أو «إلقاء غير قانوني للنفايات» أو «مركبة في منطقة محظورة»، وإسنادها إلى الكاميرات، وتلقّي الأحداث عبر مسارات العمل القائمة في IREX للتنبيه والبحث والتحقيق.
يستكشف كثير من المورّدين النماذج متعددة الوسائط، لكن الفارق يكمن في موضع نموذج الرؤية واللغة ضمن سير العمل التشغيلي، وفي الضمانات المعمول بها. ففي IREX، تخضع أحداث StreamVLM لإطار الحوكمة نفسه الذي تخضع له التحليلات المدرَّبة: الوصول المستند إلى الأدوار، وتسجيل الموجّهات النصية والأحداث، والاستدلال المحلي داخل نسخة العميل، والمراجعة البشرية قبل أي استجابة.
يوسّع IREX StreamVLM™ منصة فيديو للسلامة العامة بكواشف تُحدَّد بموجّهات نصية: وصف حالة خاصة بالموقع، ونشرها على كاميرات محددة، وتحويلها إلى حدث في الوقت الفعلي قابل للتدقيق.