
 Bem-estar
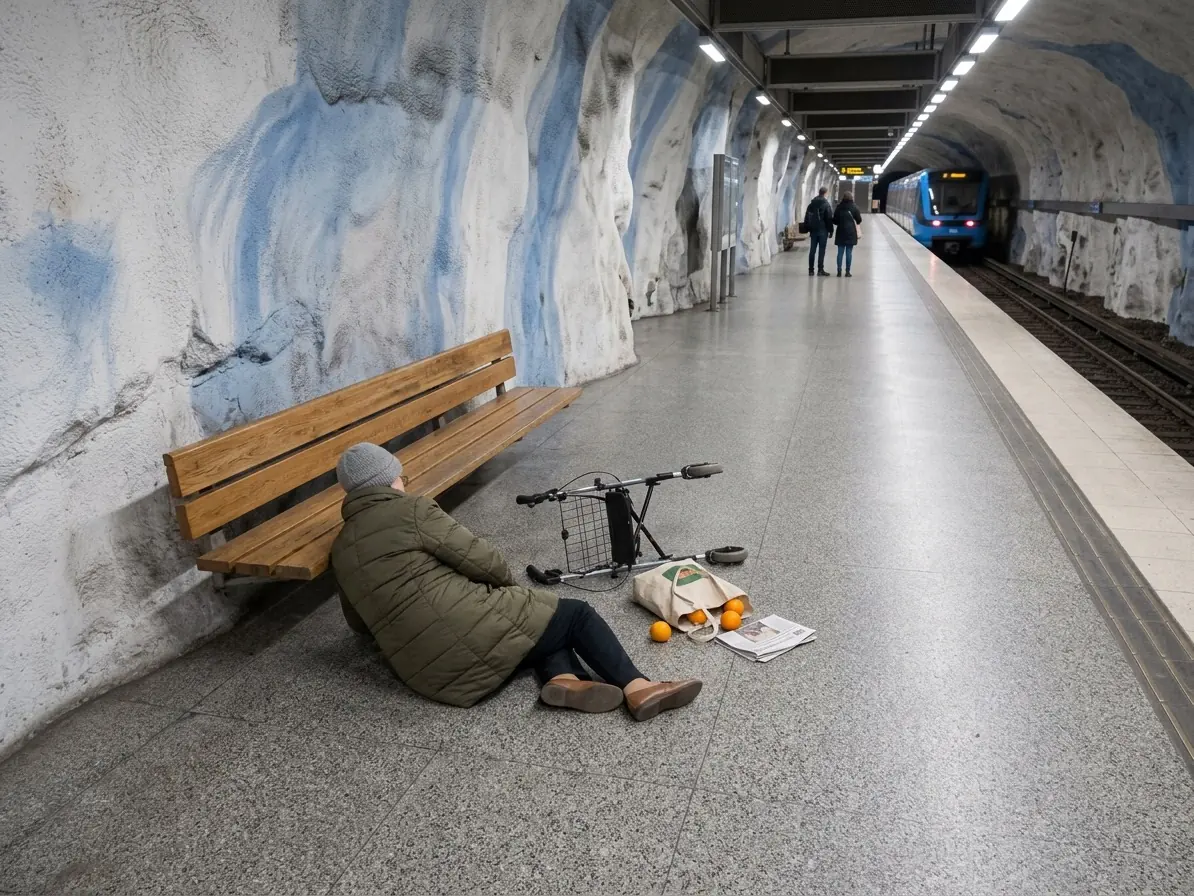
Detecção de Pessoas no Chão
Uma pessoa deitada no chão.
Saiba Mais
A análise de vídeo convencional exige meses de coleta de dados, rotulagem e treinamento para cada novo caso de uso. StreamVLM™ utiliza um modelo de visão e linguagem que já compreende imagens e linguagem. Assim, um detector descrito em uma frase começa a funcionar imediatamente.
A Variedade de Necessidades Pouco Comuns
Cada cidade precisa ver situações para as quais nenhum fornecedor de análise vende um módulo: uma pessoa deitada no chão, uma cerca danificada ou descarte irregular de resíduos atrás de um depósito. Isoladamente, nenhuma justifica um programa de treinamento. Juntas, representam a maior parte do que realmente preocupa um município. A biblioteca visual abaixo reúne 24 dessas condições, com a vista de câmera e a página que explica cada uma.
StreamVLM™ atende a essa necessidade. Um operador escreve a condição em inglês simples; o mecanismo avalia os quadros ao vivo com base na instrução. As correspondências geram alertas em tempo real como qualquer outro evento. Cada canal de câmera aceita vários detectores simultâneos baseados em instruções, cada um com limiar de confiança, intervalo entre alertas e tipo de evento próprios.
StreamVLM™ está incluído no preço padrão da IREX: não há cobrança separada de licença, módulo ou assinatura. O único custo adicional é um nó GPU local para inferência VLM quando a implantação exigir.
Exemplo
"Emita um alerta quando uma pessoa estiver deitada no chão." Não existe um conjunto de dados de pessoas caindo em plataformas para treinamento. Coletá-lo não seria prático nem digno. Um modelo de visão e linguagem não precisa dele: já compreende a cena, por isso a instrução é a especificação.

Biblioteca de Casos de Uso
Explore 24 condições definidas por instruções, cada uma com uma imagem ilustrativa de câmera e sua própria página. Um fluxo de trabalho treinado relacionado a veículos de duas rodas completa a biblioteca visual.
Bem-estarUma pessoa deitada no chão.
Saiba Mais →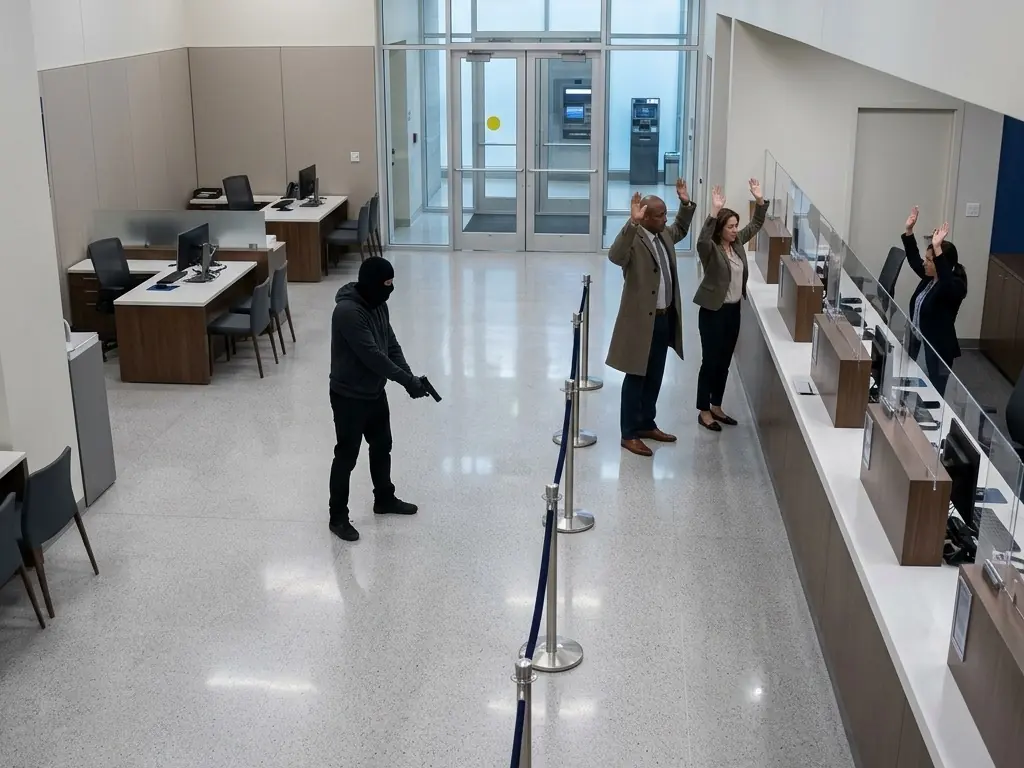 Segurança
Mãos levantadas durante um possível incidente de segurança.
Saiba Mais →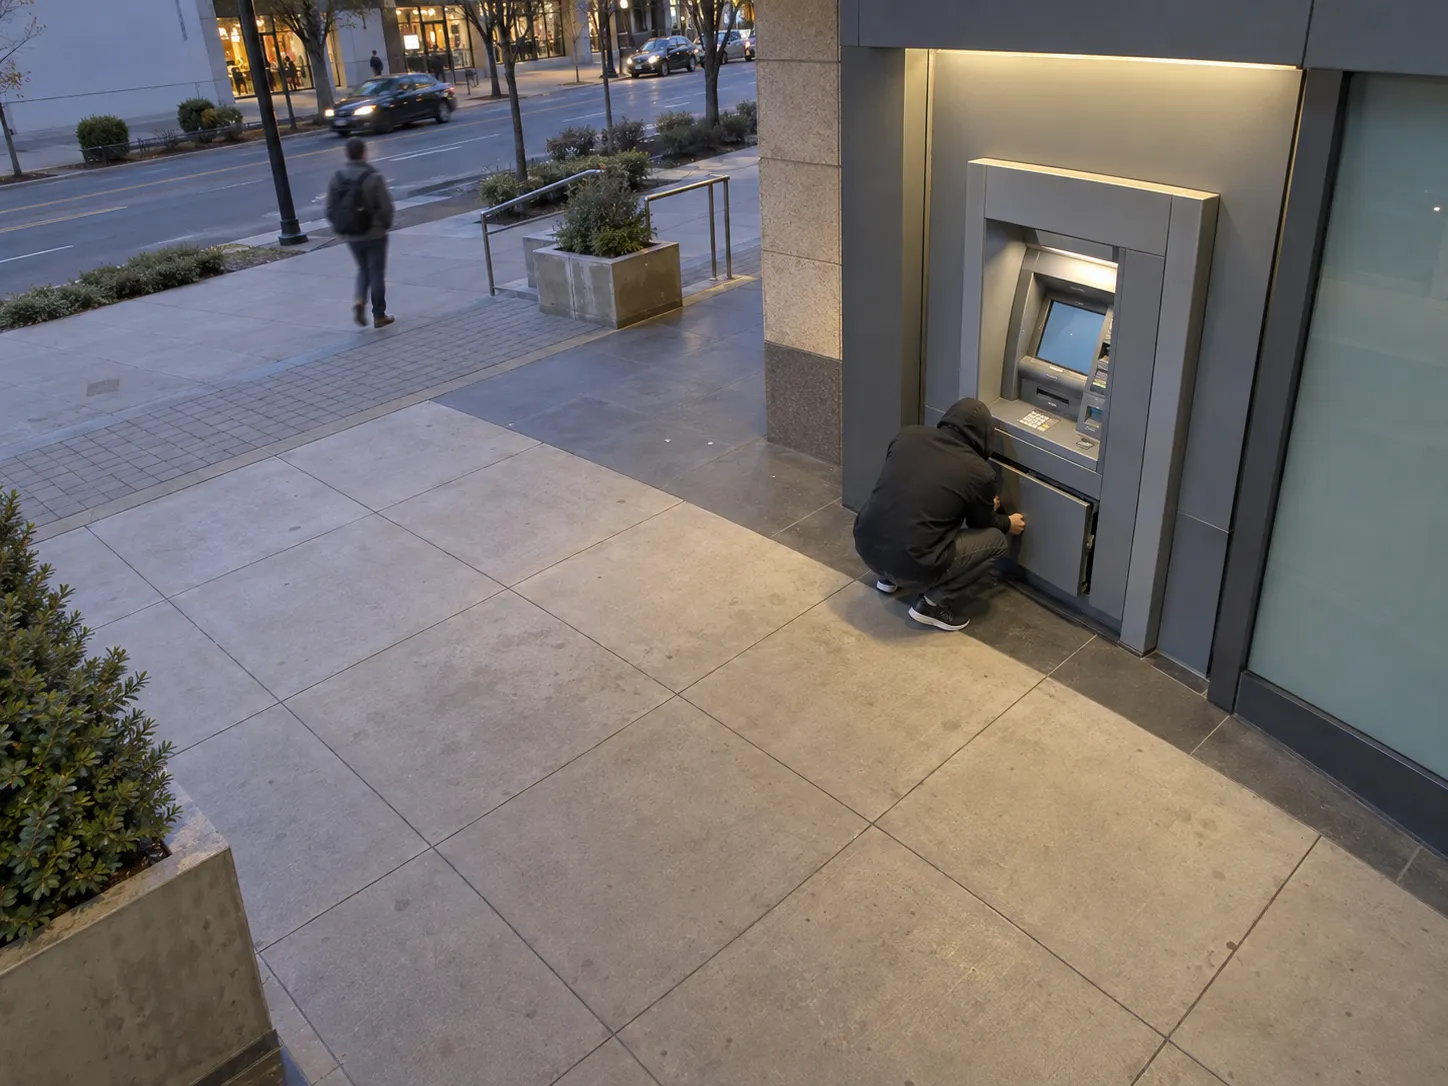 Segurança financeira
Interferência visível ou um cliente sob ameaça.
Saiba Mais →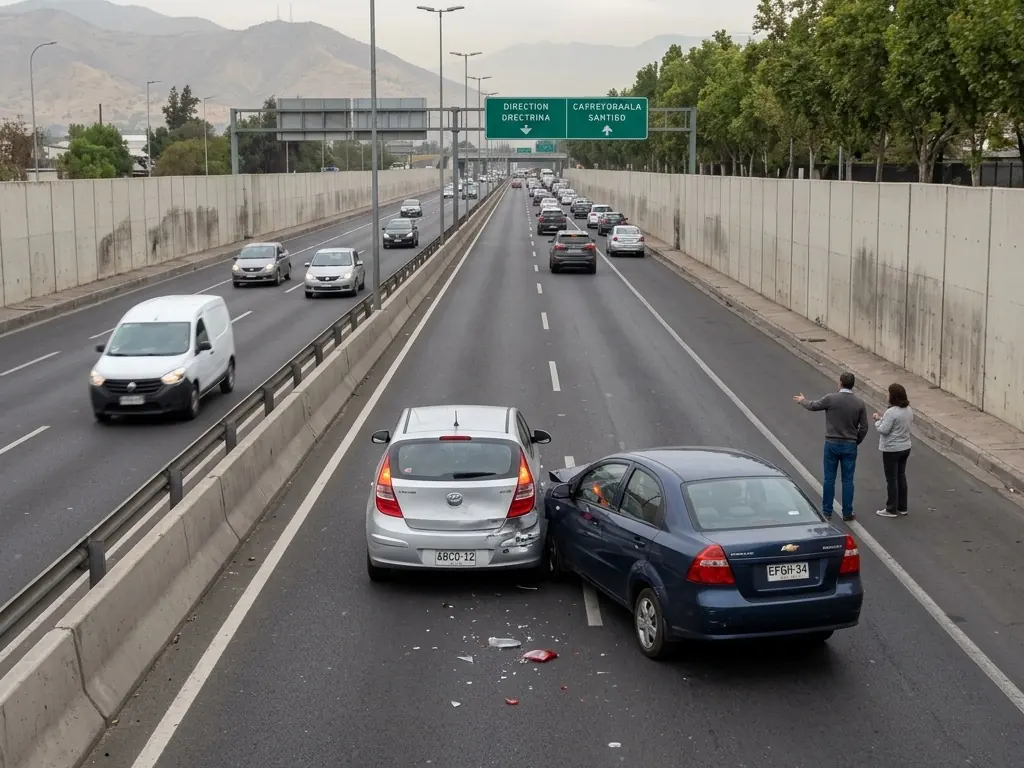 Segurança viária
Uma colisão ou um veículo imobilizado na via.
Saiba Mais →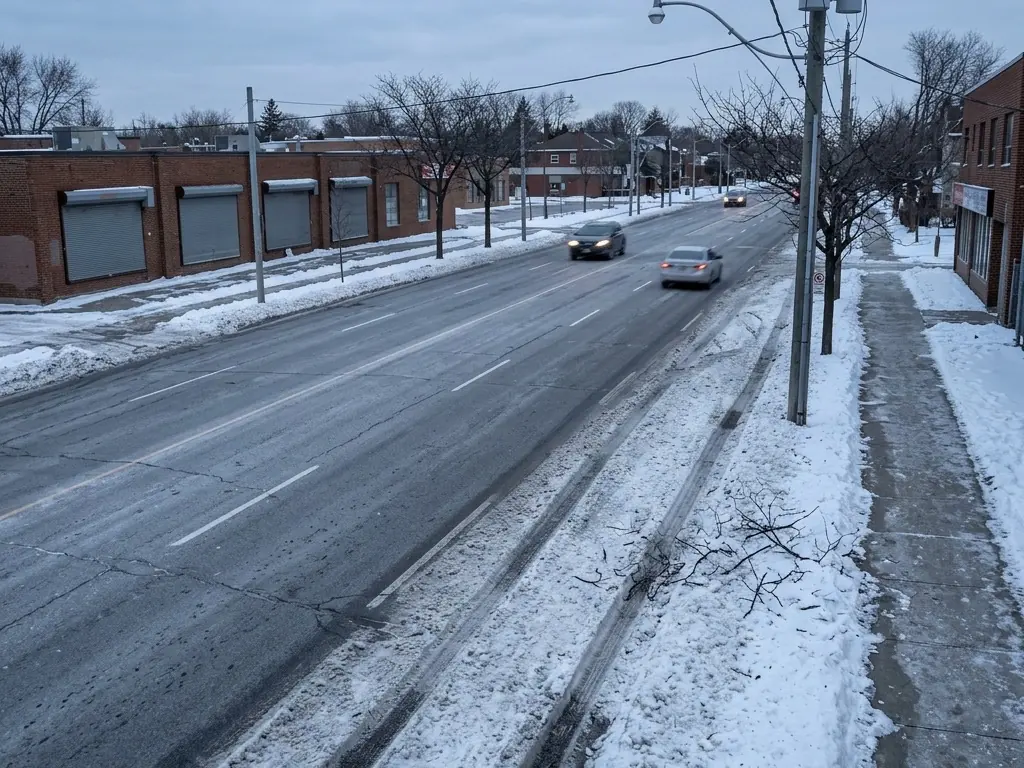 Manutenção viária
Objetos bloqueando uma faixa ou travessia.
Saiba Mais →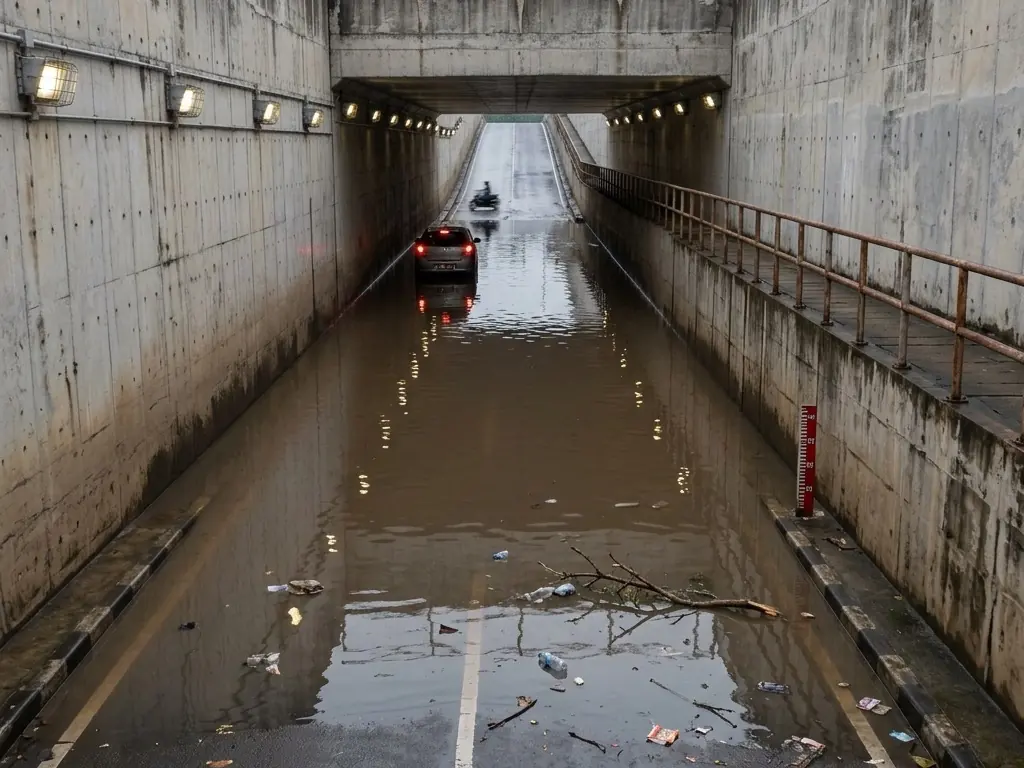 Alagamentos
Água acumulada em uma passagem inferior ou rua.
Saiba Mais →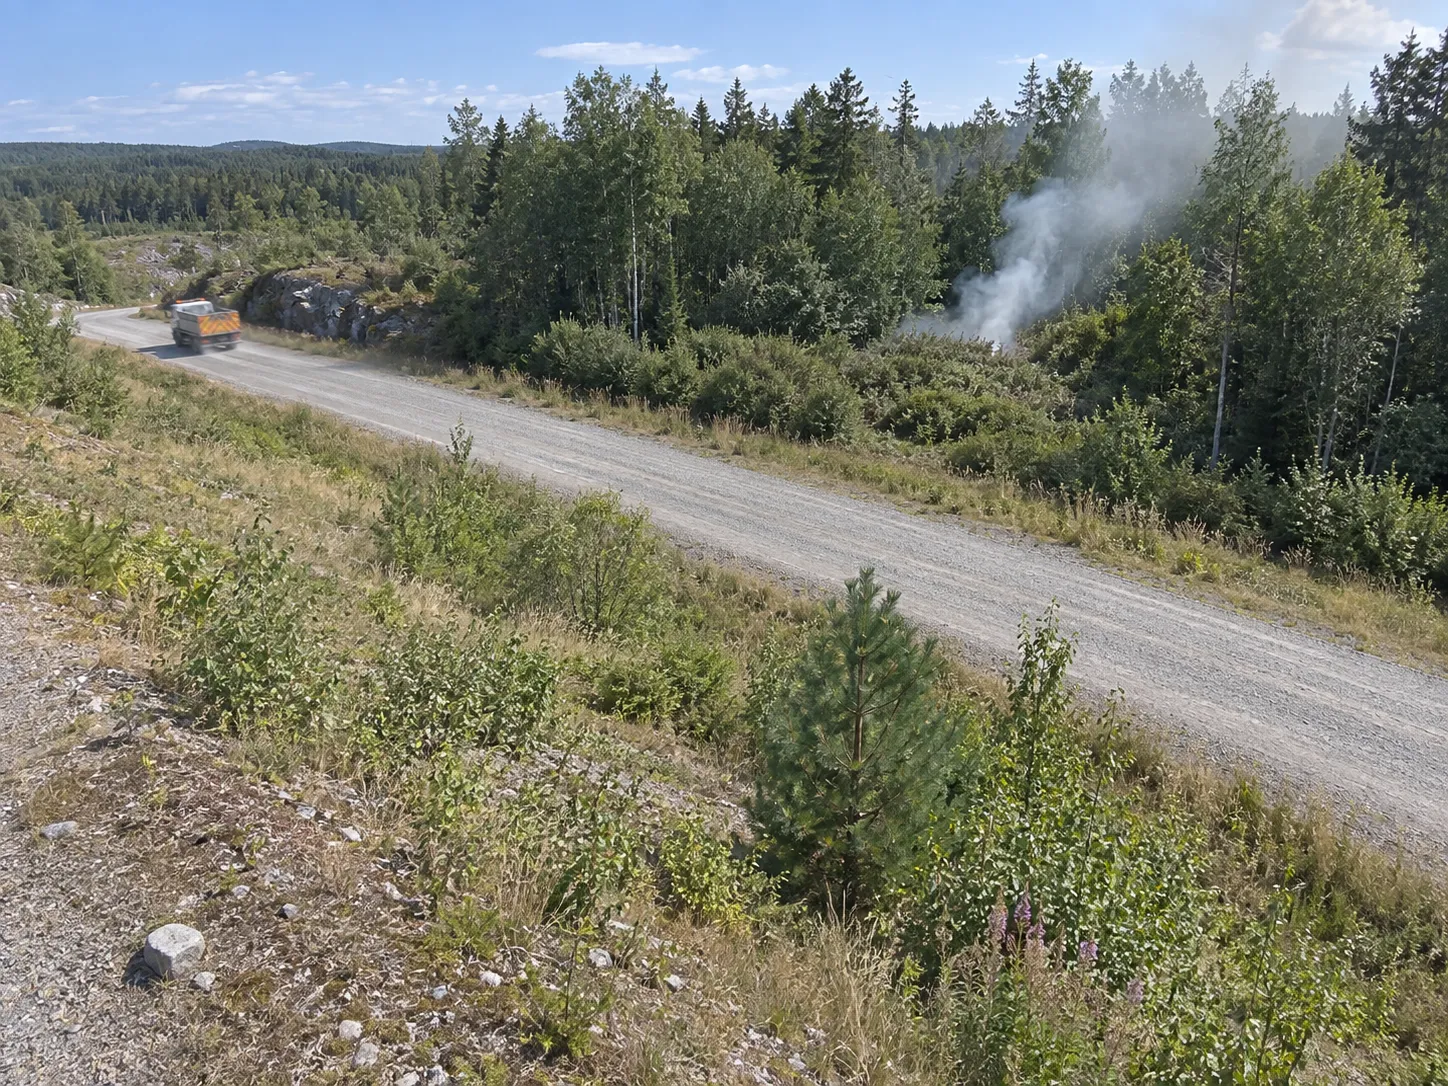 Fogo e fumaça
Fumaça ou fogo visível perto de um espaço aberto.
Saiba Mais →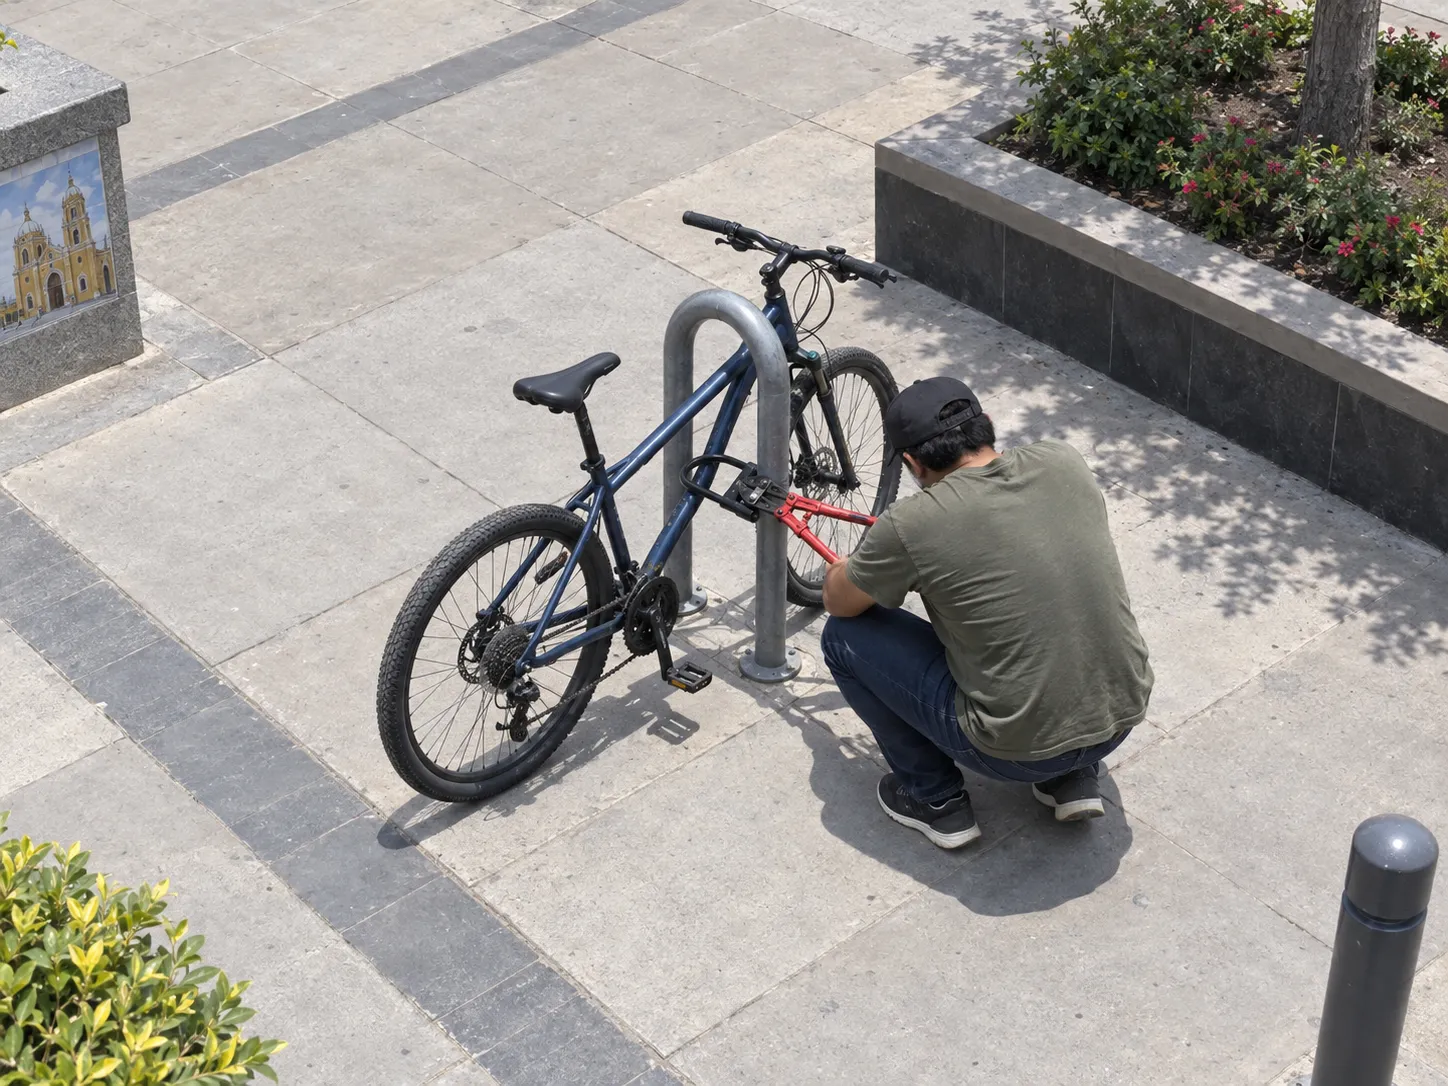 Furto
Alguém forçando o cadeado de uma bicicleta.
Saiba Mais →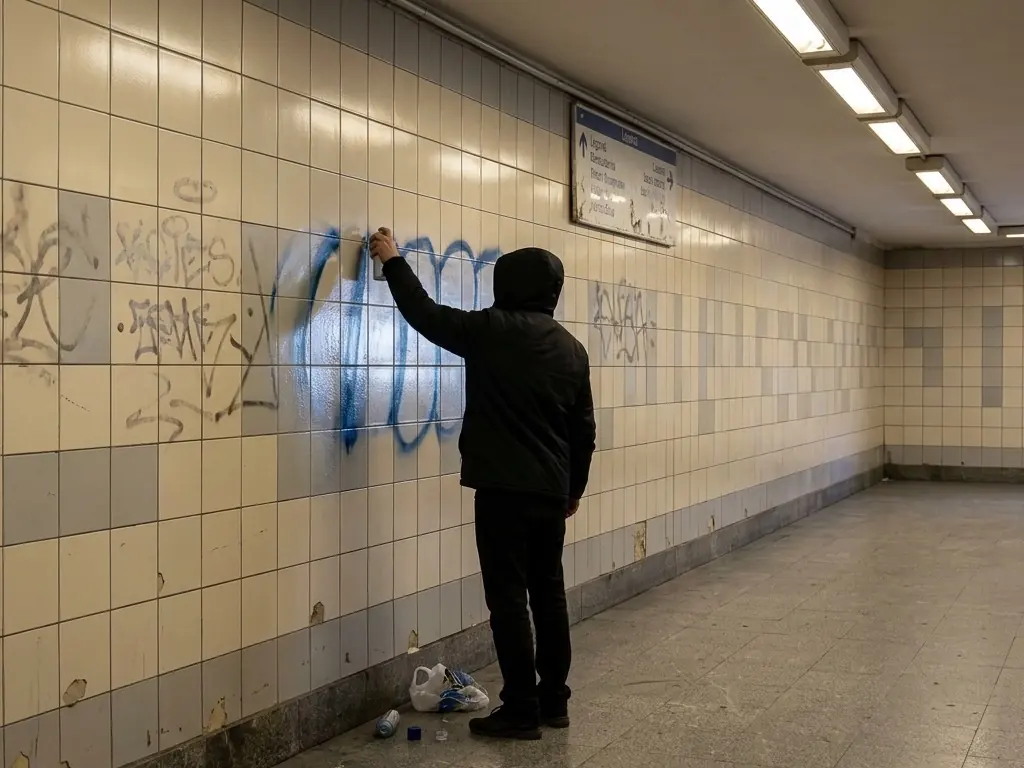 Espaço público
Uma pessoa usando spray ou fazendo marcas em uma superfície.
Saiba Mais →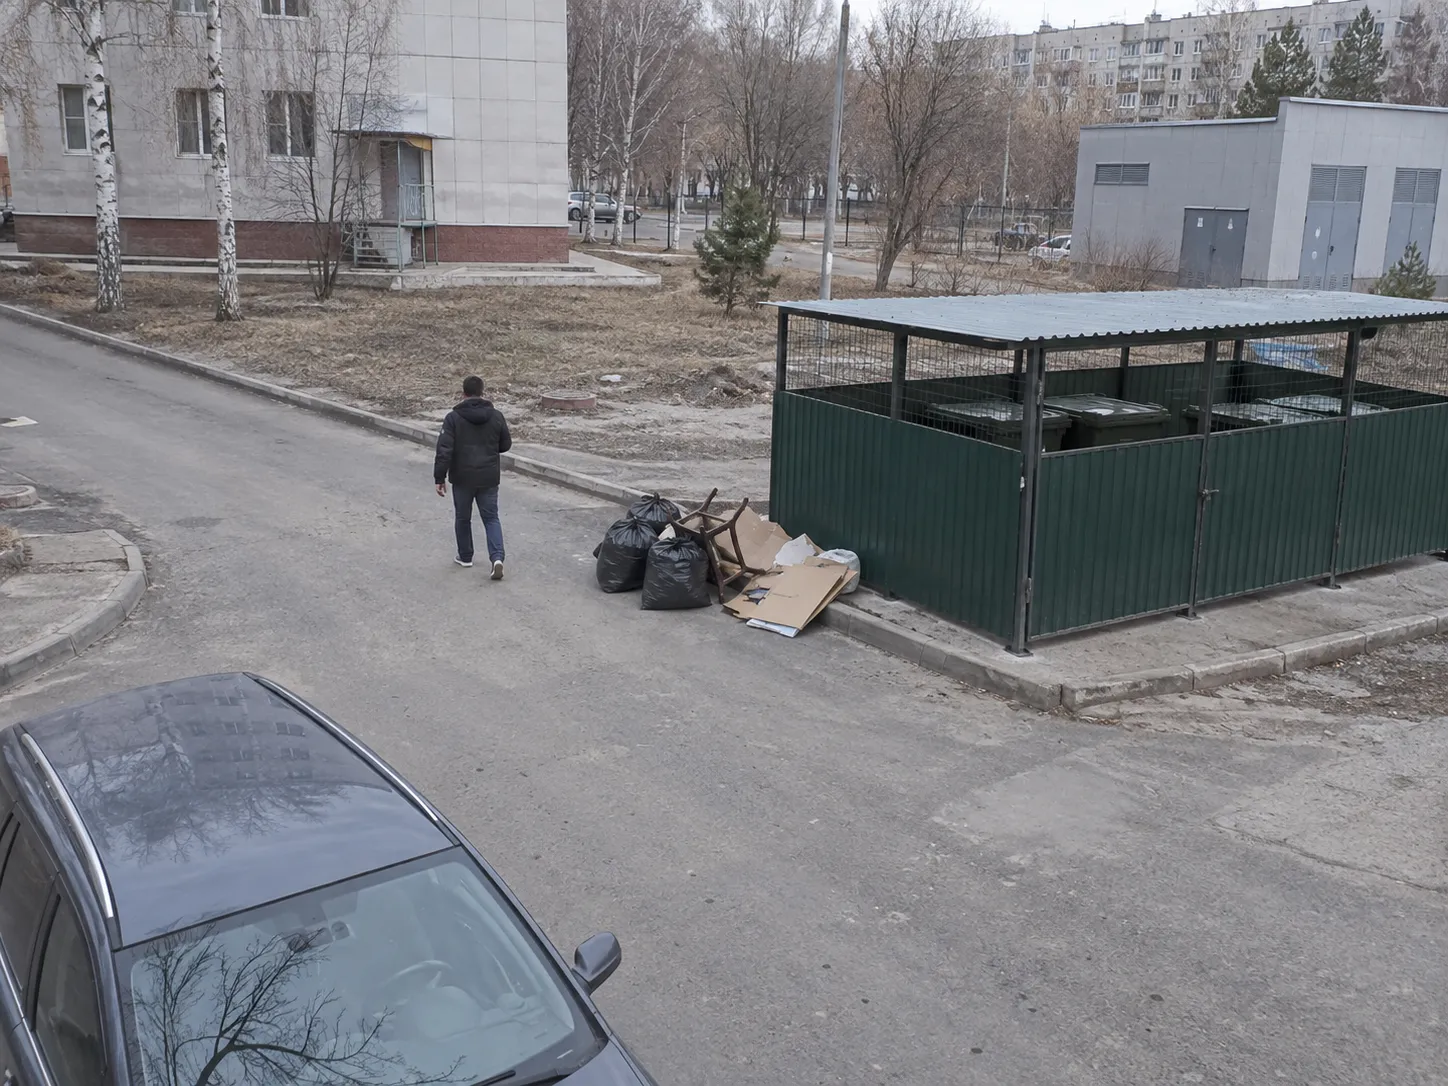 Serviços municipais
Resíduos deixados em um espaço público monitorado.
Saiba Mais →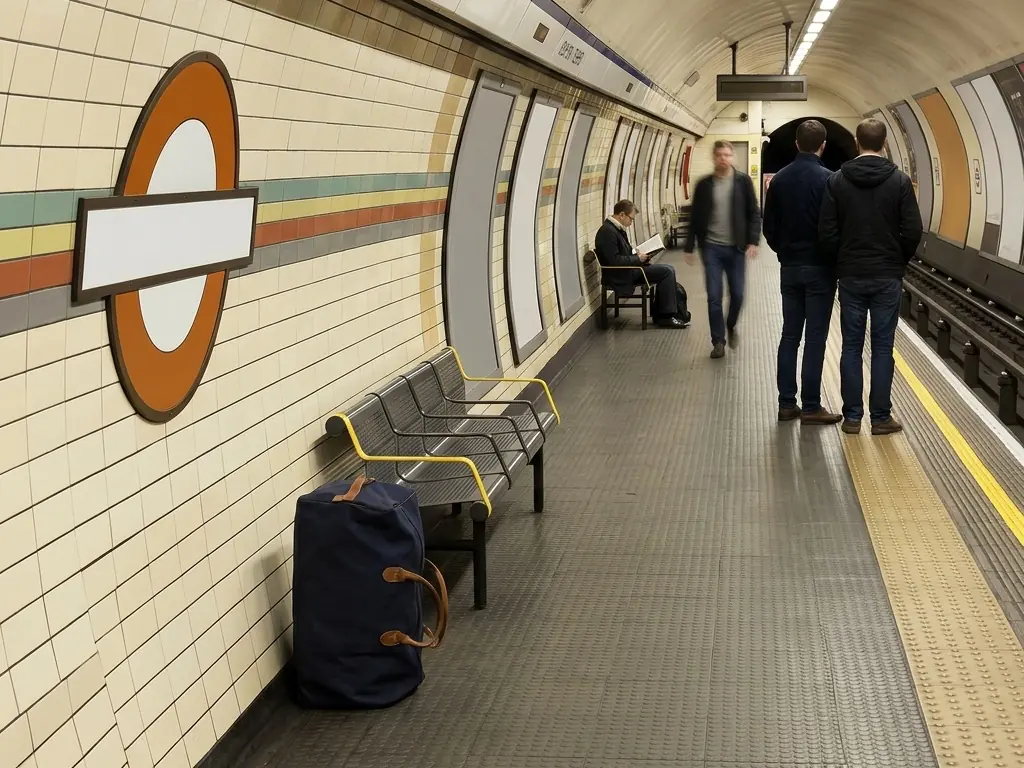 Segurança do transporte
Uma bolsa deixada separada de seu proprietário.
Saiba Mais →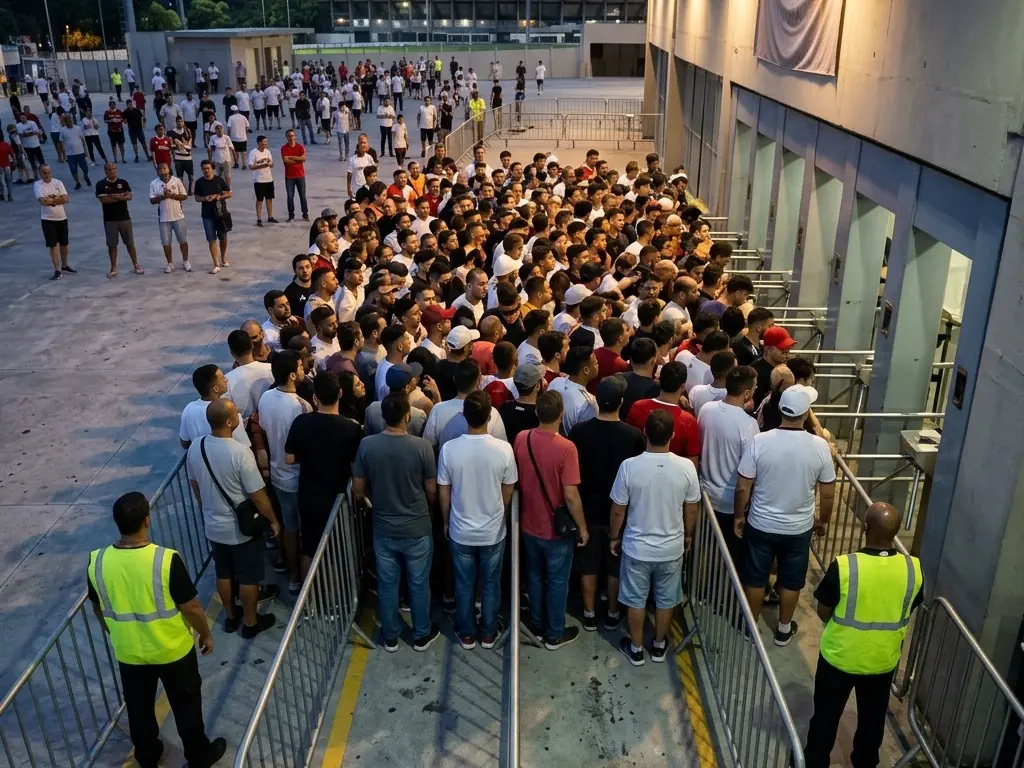 Segurança de multidões
Uma multidão atingindo uma densidade perigosa.
Saiba Mais → Segurança na travessia
Um veículo que não dá passagem a um pedestre.
Saiba Mais → Espaço de pedestres
Uma moto entrando em um espaço de pedestres.
Saiba Mais →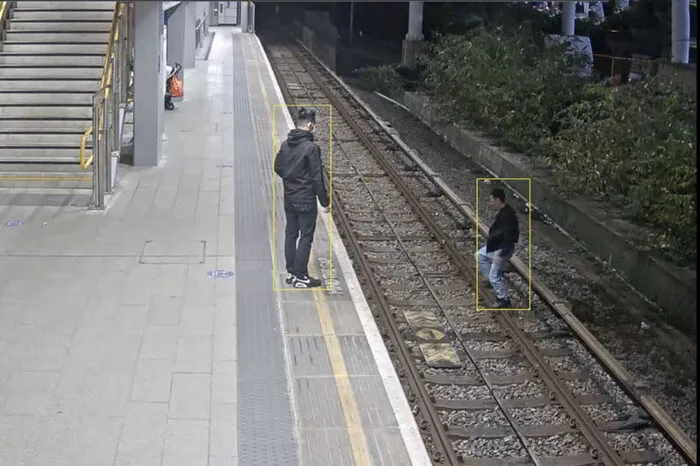 Segurança ferroviária
Alguém entrando na área dos trilhos.
Saiba Mais → Segurança viária
Animais de criação ou silvestres em uma faixa de circulação.
Saiba Mais → Segurança do local
Entrada em uma área restrita após o horário.
Saiba Mais →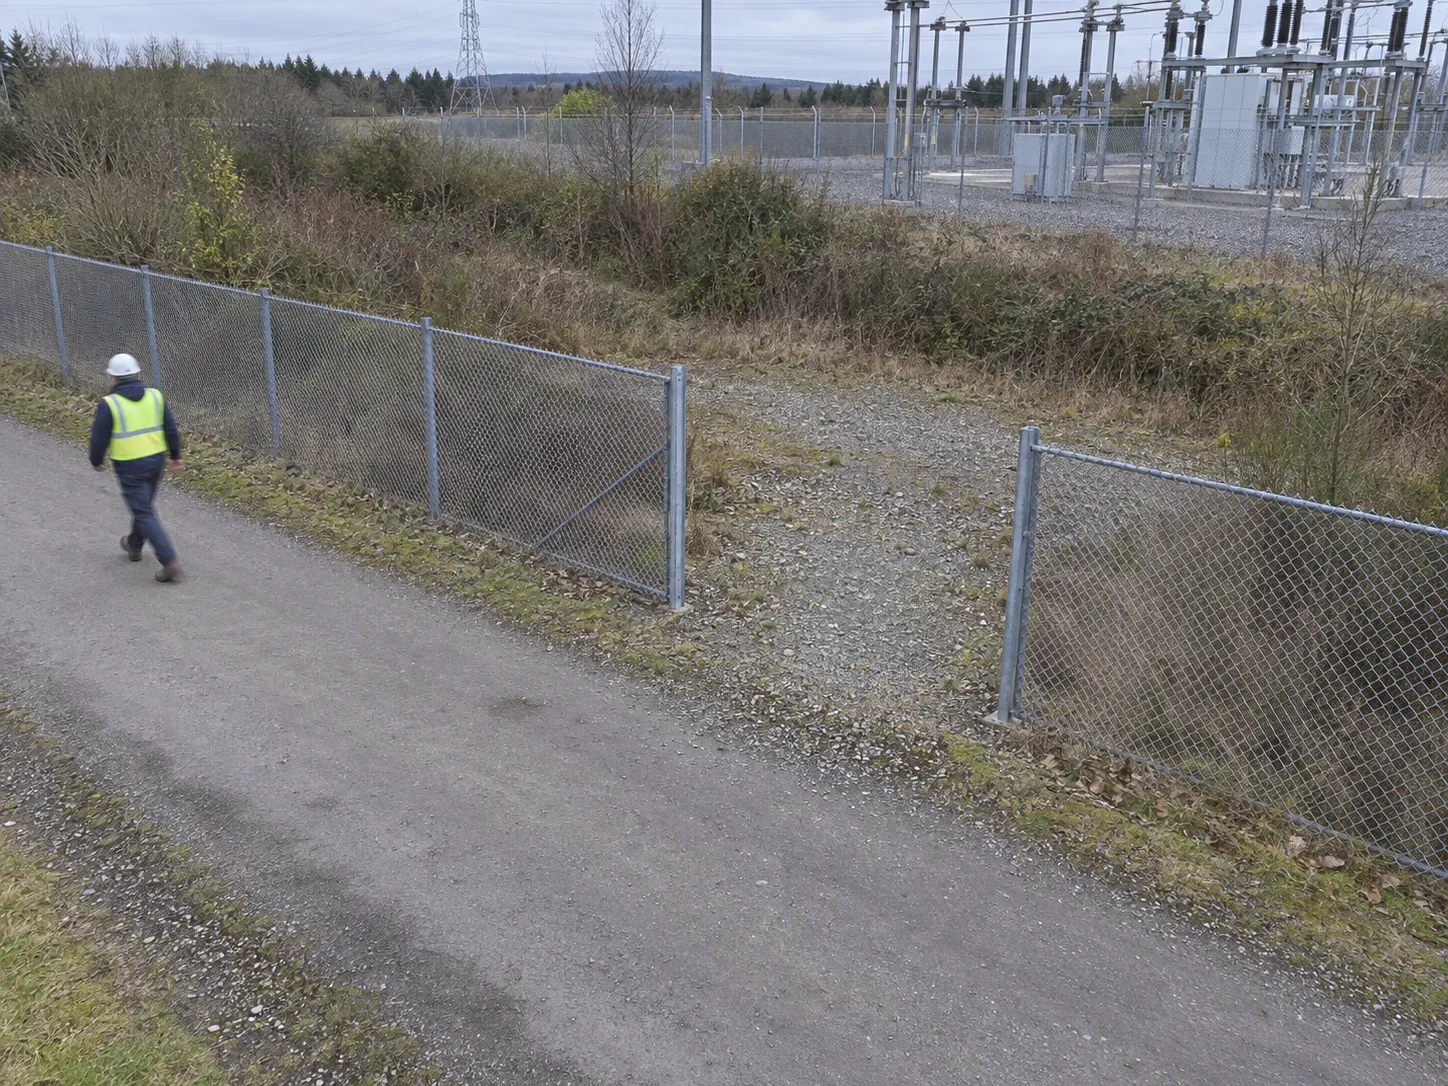 Perímetro
Uma seção quebrada de um perímetro de segurança.
Saiba Mais → Espaço aéreo
Uma pessoa lançando um drone nas proximidades.
Saiba Mais → Unidades prisionais
Um celular ou tablet visível em uma área restrita.
Saiba Mais →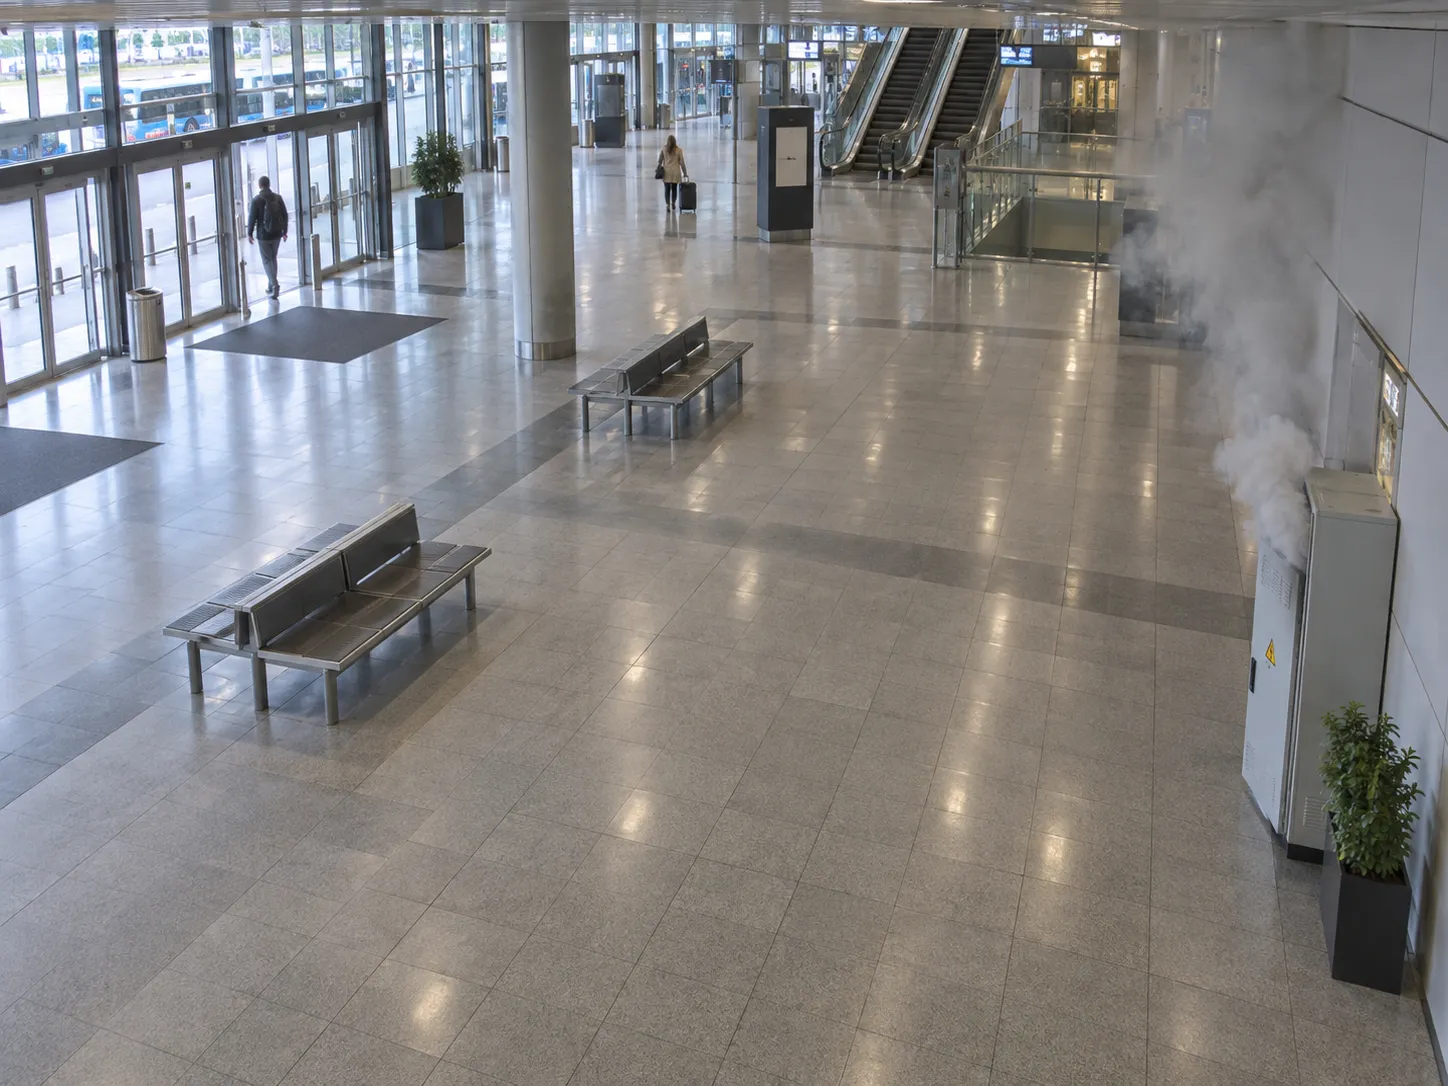 Fogo e fumaça
Fumaça visível dentro de um terminal ou edifício.
Saiba Mais →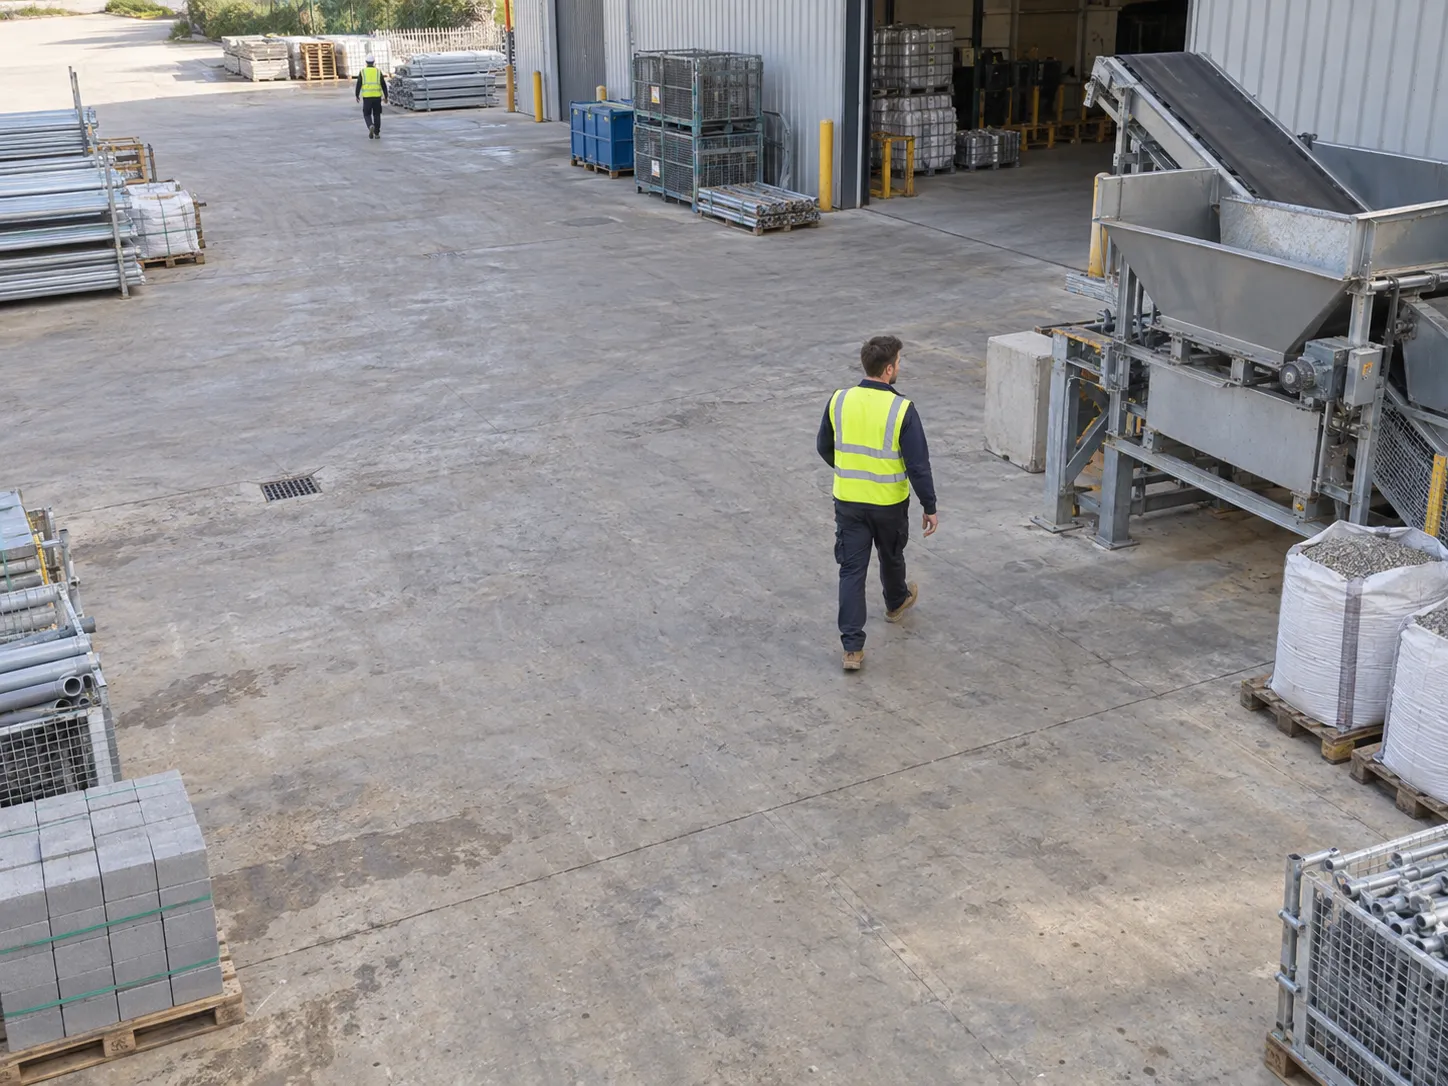 Segurança do trabalho
Um trabalhador perto de máquinas sem o equipamento obrigatório.
Saiba Mais → Estado das câmeras
Uma vista de câmera bloqueada ou degradada.
Saiba Mais → Segurança do local
Um veículo onde o acesso é limitado.
Saiba Mais → Módulo treinado relacionado
Uma motocicleta com dois ocupantes perto de um caixa eletrônico. Explore o módulo treinado relacionado e deixe que um agente analise o clipe.
Saiba Mais →O que o Diferencia
Sem coleta de dados, rotulagem nem modelo específico por caso de uso. Um novo detector é uma frase e funciona desde o momento em que é salvo.
Projetado para substituir e unificar vários módulos anteriores, entre eles a detecção de fogo, o monitoramento da qualidade de vídeo e a detecção de violação.
O limiar de confiança, o intervalo entre alertas e o tipo de evento são configurados individualmente, para que uma condição com muitos alertas não sobrecarregue o operador.
Cada instrução, quadro analisado, alerta e ação de agente é registrado com horário, identidade do operador e identificador do caso, sob acesso baseado em papéis.
Os eventos do StreamVLM chegam aos mesmos três modos dos módulos clássicos: alertas em tempo real, investigações no arquivo e exportação de Big Data.
Um detector definido por instruções opera dentro do mesmo modelo ético dos módulos treinados, incluindo a regra de restrições estritas.
StreamVLM funciona em um nó GPU na instância do cliente. A equipe de engenharia da IREX confirma se uma implantação específica está incluída; isso não é prometido antecipadamente.
Não. StreamVLM está incluído no preço padrão da IREX, sem cobrança separada de licença, módulo ou assinatura. Se a implantação precisar de um nó GPU local para inferência VLM, seu dimensionamento e preço serão definidos com a equipe de engenharia da IREX.
Vários. Um canal de câmera executa vários detectores definidos por instruções ao mesmo tempo, cada um com limiar de confiança, intervalo entre alertas e tipo de evento próprios. A IREX ainda não publica um limite por câmera: a densidade depende do hardware do cliente e é medida com suas próprias câmeras durante o piloto.
Foi projetado para unificar vários deles, incluindo detecção de fogo, monitoramento da qualidade de vídeo e detecção de violação. Os detectores treinados que operam em altas taxas de quadros continuam sendo a ferramenta adequada para acompanhar pessoas e veículos em movimento rápido.
Um modelo de visão e linguagem de pesos abertos publicado por terceiros e usado como é publicado. A IREX não faz ajuste fino nem modifica seus pesos; fixa sua versão e soma de verificação. O modelo é servido apenas em endpoints designados dentro de sua instância, no nó GPU dessa instância. Nenhum quadro, instrução ou avaliação sai dela e nenhuma instância em qualquer região usa inferência em nuvens de terceiros. O modelo não chama ferramentas, não mantém memória entre quadros e não tem acesso ao arquivo, à base de eventos, às listas de observação, a outras câmeras nem à rede. Também não tem função biométrica: avalia cenas e condições e não pode identificar uma pessoa. A IREX não publica qual modelo utiliza; identidade, versão e soma de verificação são comunicadas ao cliente sob acordo de confidencialidade. Nomear o modelo cria uma superfície de ataque e comunica uma informação que fica desatualizada. A parte B da Política de governança de modelos de IA pública estabelece todas essas regras.
Continue Lendo
Traga as condições que realmente preocupam sua cidade. Se uma instrução puder descrevê-las, normalmente podemos mostrar um detector para elas durante o piloto.