
IREX StreamVLM™: Analítica de Video Definida por Instrucciones
Con IREX 4.43 (dic. 2026–ene. 2027), StreamVLM™ convierte una descripción en inglés sencillo en un detector en vivo, verificado por un VLM, que funciona en sus instalaciones en miles de cámaras.
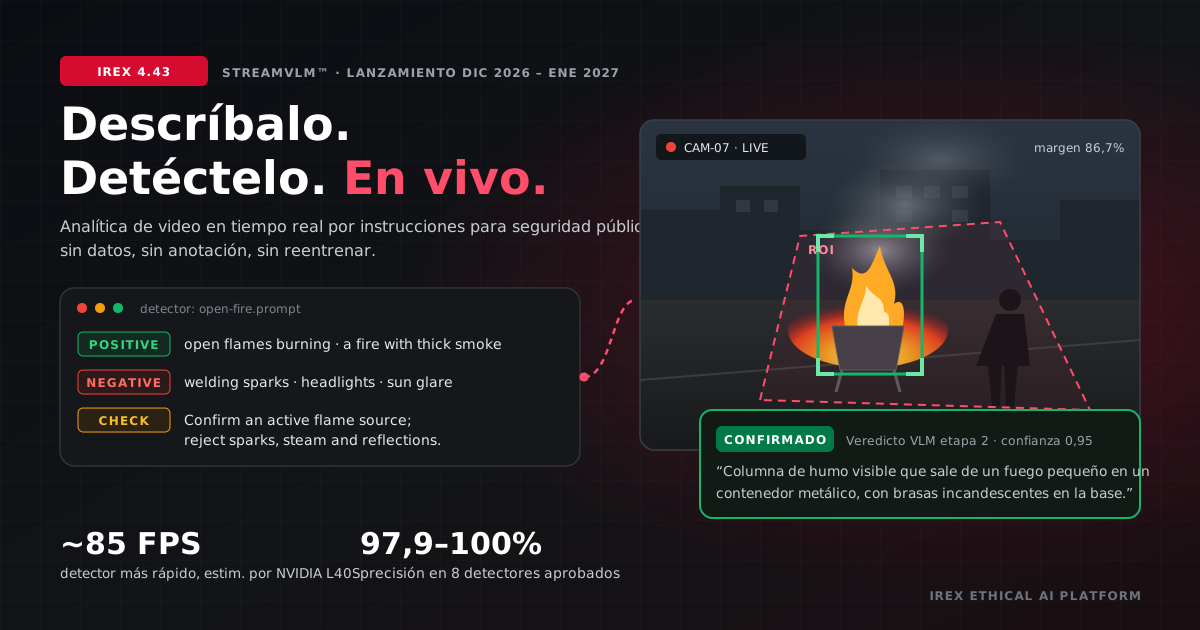
MURRIETA, CA — IREX (IrexAI Inc.), desarrolladora de la IREX Ethical AI Platform para la seguridad pública, anunció hoy StreamVLM™, la primera analítica del mundo basada en un modelo de visión y lenguaje (VLM) para la seguridad pública. StreamVLM™ se incluye en IREX 4.43, cuyo lanzamiento está programado entre diciembre de 2026 y principios de enero de 2027. StreamVLM™ permite que los equipos de seguridad pública, transporte e infraestructura crítica creen detectores de video en tiempo real personalizados a partir de instrucciones de texto en inglés sencillo. No hay que reunir un conjunto de datos, ni anotar una imagen, ni volver a entrenar una red neuronal: un nuevo detector nace como una frase y puede estar funcionando en minutos, no en meses.
Lo que distingue a StreamVLM™ de los asistentes de IA de uso general, como ChatGPT o Gemini, es la eficiencia de hardware y la escala. Su arquitectura y sus modelos están diseñados a propósito para el video en vivo, de modo que una sola GPU atiende muchas más cámaras de las que podría un modelo de uso general, y la plataforma IREX orquesta cientos de escenarios de StreamVLM™ en miles de cámaras. Además, StreamVLM™ funciona en las instalaciones del cliente (on premises), dentro de su propia infraestructura: ningún video ni dato sale del país ni de la red privada.
El Problema que Resuelve StreamVLM™
Cada nuevo peligro ha implicado tradicionalmente un nuevo modelo. Un organismo que quería detectar algo que su analítica aún no cubría debía reunir miles de imágenes, etiquetarlas, entrenar un detector e implementarlo en sus servidores, un ciclo que toma meses por cada solicitud.
Los grandes modelos de visión y lenguaje eliminan el paso de entrenamiento porque entienden con palabras lo que ven. También son lentos: una sola llamada a un VLM toma aproximadamente de 1 a 2 segundos por fotograma en una GPU, mientras que una red de cámaras en producción necesita decenas de fotogramas por segundo por GPU en muchas transmisiones. Apuntar un VLM a cada fotograma de cada cámara no es práctico.
StreamVLM™ resuelve esa tensión con un embudo de dos etapas que gasta GPU solo donde importa, y alcanza una precisión de 97,9–100,0% en sus ocho segmentos de detección aprobados para producción.
Cómo Funciona el Embudo de Dos Etapas
En una red de cámaras real los incidentes críticos son poco frecuentes: la inmensa mayoría de los fotogramas muestra actividad rutinaria. StreamVLM™ coloca un filtro multimodal rápido delante de un verificador VLM cuidadoso, de modo que el cómputo pesado de GPU se gasta solo cuando realmente está ocurriendo algo.
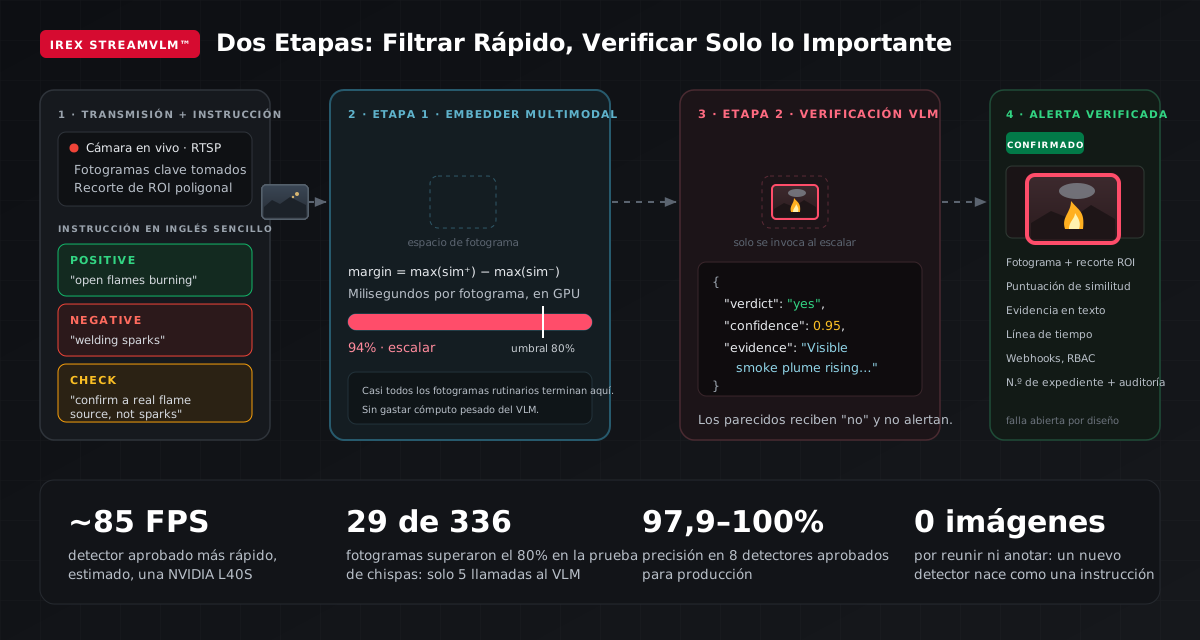
- Etapa 1: Generador de Embeddings Multimodal Rápido (filtro de margen semántico). La plataforma toma fotogramas clave de la transmisión en vivo, o de una región de interés (ROI) poligonal dentro de ella, y proyecta cada fotograma en un espacio de embeddings compartido de visión y lenguaje. Lo compara con frases objetivo
POSITIVEy frases de falsa alarmaNEGATIVEalmacenadas en caché y calcula el margen de similitud en milisegundos. Los fotogramas rutinarios y los parecidos predecibles se detienen aquí. - Etapa 2: Verificación con el Modelo de Visión y Lenguaje (
CHECK). Solo cuando la puntuación de la etapa 1 supera el umbral configurado (por ejemplo 80%) y se mantiene durante la duración requerida, StreamVLM™ llama al VLM. Guiado por la instrucciónCHECKdel detector, el VLM inspecciona la escena y devuelve un veredicto estructurado en JSON (yesono), una puntuación de confianza y una descripción en inglés sencillo de la evidencia que vio.
El efecto es fácil de medir. En un video de 5 minutos de un patio industrial muestreado a 1 FPS (336 verificaciones de fotogramas), unos trabajadores produjeron chispas cerca de un brasero metálico durante cuatro minutos. Con «chispas de soldadura en una obra de construcción» configurado como ancla negativa, esas chispas puntuaron entre 55% y 76%, por debajo del umbral del 80%. Solo 29 de los 336 fotogramas superaron el umbral y se fusionaron en apenas 5 llamadas al VLM de la etapa 2, una reducción de más del 91% en las invocaciones al VLM. Cuando surgieron llamas reales, StreamVLM™ confirmó los tres episodios de fuego con 95% de confianza.
Instrucciones de Tres Partes: Falsas Alarmas Eliminadas desde el Diseño
Los modelos de embeddings de texto a imagen manejan mal la negación. Una instrucción para «sin humo» sigue coincidiendo con la palabra «humo», y una instrucción solo positiva para «camellos en la carretera» puede activarse con un caballo que pasa, porque ambos animales están más cerca entre sí en el espacio de embeddings que cualquiera de ellos respecto del asfalto vacío.
Por eso StreamVLM™ no depende de una sola oración. Los administradores construyen cada detector en el Catálogo de Detectores VLM de todo el sistema a partir de tres partes:
POSITIVE(1–16 frases objetivo): descripciones visuales breves del evento en distintas condiciones de iluminación y ángulos de cámara.NEGATIVE(0–16 frases de confusión): no eventos conocidos y parecidos ópticos que suprimen los disparos falsos en la etapa 1.CHECK(regla de verificación de la etapa 2): criterios visuales explícitos que el VLM usa para confirmar el incidente y explicar su decisión.
Ejemplo 1: Humo de Chimenea e Industrial
POSITIVE:
thick black smoke rising from a chimney
dark gray smoke billowing from a rooftop chimney
a plume of smoke coming out of a house chimney
white smoke rising from a residential chimney
a smoking chimney over houses in winter

NEGATIVE:
white steam evaporating from a vent
fog over rooftops in the morning
low clouds over a residential area
a dirty camera lens with smudges
lens flare and sun glare in the sky
a dark tree silhouette against the sky
clear sky over houses with no smoke

CHECK:
Determine whether smoke is actively being emitted from a chimney or flue.
A real chimney smoke plume originates at a chimney mouth, is attached to it,
widens and fades as it rises, and drifts or changes shape across frames.
Distinguish steam, fog or low clouds, lens dirt, glare, and dark static objects.
If smoke is present, classify its color as white, dark, or unknown.
Ejemplo 2: Fuego Abierto frente a Chispas de Soldadura
Para detectar una quema no autorizada o un incendio incipiente en un sitio industrial sin dar falsas alarmas por el mantenimiento rutinario, los operadores combinan anclas positivas de fuego («llamas abiertas ardiendo», «un fuego con humo espeso», «un auto incendiándose») con confusores negativos como el resplandor del sol, los faros de vehículos, las bombillas encendidas y «chispas de soldadura en una obra de construcción». La etapa 1 mantiene las chispas por debajo del umbral; la etapa 2 confirma el fuego genuino y redacta evidencia que un operador puede leer de un vistazo: «Columna de humo visible que sale de un fuego pequeño en un contenedor metálico, con brasas incandescentes y material en llamas en la base.»
La misma segunda mirada rinde frutos en las calles de la ciudad. En pruebas en vivo de varios días con cámaras de vía pública, para vigilar peatones caídos, vehículos de emergencia y scooters o bicicletas en las aceras, unos promotores callejeros con disfraces de oso de cuerpo completo activaron repetidamente la similitud de forma de la etapa 1 con una persona acostada. Cada vez, el VLM de la etapa 2 volvió a mirar y rechazó la alarma.
Rendimiento Aprobado para Producción
Cada perfil de detector de StreamVLM™ se valida antes de ser aprobado. El criterio de liberación es estricto: un detector se despliega solo cuando alcanza al menos 97,0% de precisión y al menos 90,0% de exhaustividad en datos de prueba reservados.
Exactitud medida para los ocho segmentos de detección aprobados para producción, con el rendimiento esperado en una NVIDIA L40S, la GPU de centro de datos que IREX opera en sus instalaciones de Dallas para clientes de EE. UU.:
| Segmento de Detección | Precisión | Exhaustividad | Puntuación F1 | Rendimiento Esperado (1× NVIDIA L40S) |
|---|---|---|---|---|
| Arma en el Fotograma (Detección de Armas) | 98,9% | 95,8% | 0,973 | ~3 FPS |
| Humo y Fuego (Fuego y Humo) | 99,2% | 96,1% | 0,976 | ~11 FPS |
| Cualquier Humo (Fuego, Chimenea, Escape) | 98,2% | 94,7% | 0,964 | ~51 FPS |
| Humo de Fuego Peligroso (Fuego frente a Vapor o Escape) | 97,9% | 92,0% | 0,949 | ~85 FPS |
| Obras Viales y Zonas de Construcción | 97,9% | 97,9% | 0,979 | ~40 FPS |
| Venta Ambulante No Autorizada | 100,0% | 97,1% | 0,985 | ~77 FPS |
| Sabotaje de Cámara: Desenfoque | 100,0% | 94,6% | 0,972 | ~15 FPS |
| Fauna Silvestre / Camellos en la Calzada | 100,0% | 100,0% | 1,000 | ~5 FPS |
Precisión, exhaustividad y F1 son resultados medidos en el conjunto de prueba del banco de validación de IREX. El rendimiento es una estimación de ingeniería para una NVIDIA L40S, escalada a partir de pruebas de referencia según la cantidad de núcleos de la GPU; un nodo de GPU estándar de IREX incluye dos. La precisión en el mundo real depende de la ubicación de las cámaras, la iluminación y la configuración de la región de interés.
La Frecuencia de Fotogramas Adecuada para Cada Tarea
No toda aplicación necesita mirar cada segundo de video. StreamVLM™ revisa cada cámara con el intervalo que la tarea requiere, y ese intervalo determina cuántas cámaras puede cubrir una GPU:
- Seguridad de respuesta crítica: para la detección de fuego y humo, IREX recomienda revisar un fotograma cada 10 a 30 segundos para una respuesta rápida.
- Condiciones de cambio lento: para el monitoreo del lente de las cámaras o el control de la limpieza de calles, StreamVLM™ puede revisar un fotograma cada 10 a 60 minutos.
Como el rendimiento se reparte entre las cámaras, un intervalo más largo multiplica la cobertura. Con un fotograma cada 30 segundos, un detector que opera a ~85 FPS podría, en principio, cubrir más de 2.000 canales de cámara en una sola L40S, y con intervalos de minutos la misma GPU llega mucho más lejos. Eso es lo que permite a StreamVLM™ escalar a los miles de cámaras de una ciudad o de un estado. El dimensionamiento final de cada implementación lo realiza la ingeniería de IREX.
Diseñado para el Control Operativo y la Gobernanza de IA Ética
StreamVLM™ se integra con los flujos de trabajo existentes de los centros de mando de IREX:
- Prueba de detectores con un solo fotograma: antes de que un detector entre en operación, los administradores prueban la instrucción con una captura en vivo de una cámara o con una imagen JPEG o PNG cargada y ven la puntuación de similitud exacta, el veredicto del VLM y su explicación.
- Varios detectores por cámara: varios detectores de StreamVLM™ pueden funcionar en un mismo canal de cámara, cada uno con su propia ROI poligonal. Cuando los detectores comparten una ROI, la etapa 1 calcula el embedding del fotograma una sola vez y lo reutiliza para cada regla activa. El límite por cámara depende del hardware del cliente y se confirma durante el piloto.
- Falla abierta por diseño: si el servicio de verificación del VLM no está disponible por un breve lapso durante un pico de carga, StreamVLM™ igualmente genera la alerta de la etapa 1 y la marca como «Verificación adicional no realizada», de modo que un incidente de seguridad urgente nunca se descarte en silencio.
- Transparency by Design y rendición de cuentas: cada alerta de StreamVLM™ incluye el fotograma completo, el recorte de la ROI, el porcentaje de similitud y la evidencia en texto del VLM. La búsqueda de eventos exige un número de expediente, y cada cambio de configuración y cada búsqueda quedan registrados en el registro de auditoría inmutable, con permisos dedicados de control de acceso basado en roles (RBAC).
Disponibilidad y Hoja de Ruta
La generación de alertas en tiempo real de StreamVLM™ se incluye en IREX 4.43, cuyo lanzamiento está programado entre diciembre de 2026 y principios de enero de 2027. Funciona en un nodo de GPU dentro de la implementación de IREX del cliente, dimensionado por la ingeniería de IREX, mientras el resto de la plataforma sigue funcionando en servidores estándar. La búsqueda retrospectiva en lenguaje natural basada en descriptores en archivos de video almacenados está en la hoja de ruta de producto de IREX para 2027.
Acerca de IREX
IREX es una Plataforma de IA Ética para la seguridad pública, las ciudades inteligentes y la gestión del tránsito, con más de 250.000 cámaras implementadas en todo el mundo en 8 países y más de 100.000 cámaras comprobadas en una sola instancia. Construida sobre el principio de Transparency by Design, IREX convierte las redes de cámaras existentes en herramientas inteligentes y auditables, mientras los clientes conservan plena soberanía sobre sus datos.