
IREX StreamVLM™ traz análise de vídeo em tempo real definida por prompts à segurança pública
Previsto para o IREX 4.43 (dez. 2026–jan. 2027), o StreamVLM™ transforma uma descrição em linguagem simples em um detector ao vivo, verificado por um VLM, on-premises, em milhares de câmeras.
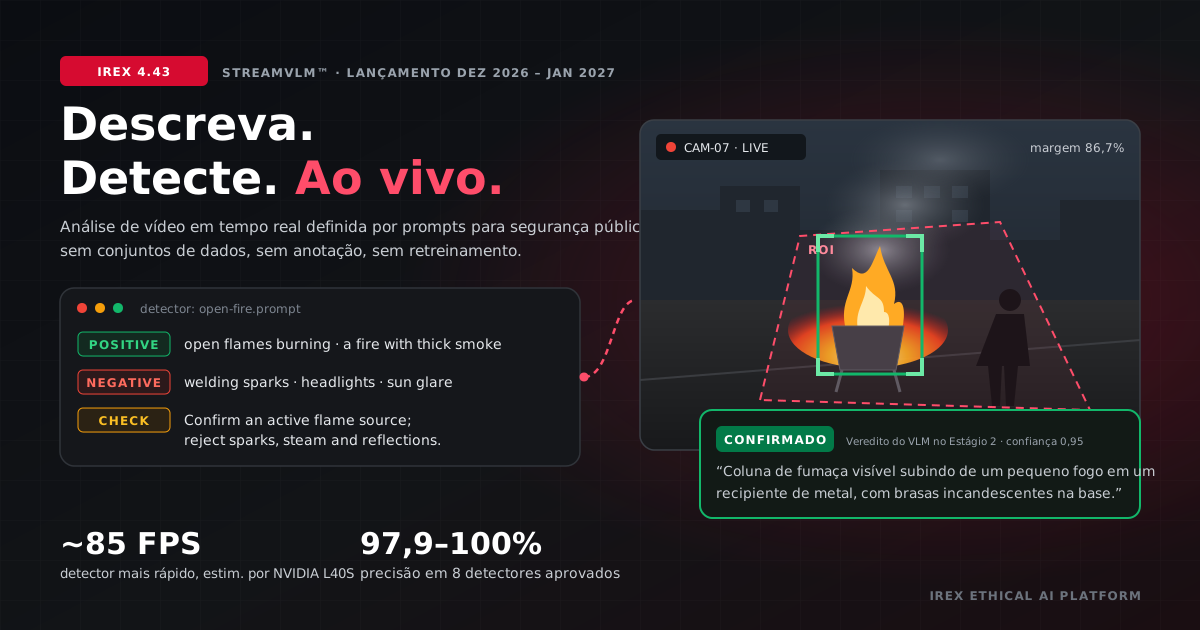
MURRIETA, CA — IREX (IrexAI Inc.), desenvolvedora da IREX Ethical AI Platform para segurança pública, anunciou hoje o StreamVLM™, a primeira análise do mundo baseada em modelo de visão e linguagem (VLM, do inglês Vision-Language Model) para segurança pública. O StreamVLM™ será entregue no IREX 4.43, com lançamento previsto entre dezembro de 2026 e o início de janeiro de 2027. O StreamVLM™ permite que equipes de segurança pública, transporte e infraestrutura crítica criem detectores de vídeo personalizados em tempo real a partir de prompts de texto em linguagem simples. Não há conjunto de dados para reunir, nem imagem para anotar, nem rede neural para retreinar: um novo detector começa como uma frase e pode estar em funcionamento em minutos, não em meses.
O que diferencia o StreamVLM™ de assistentes de IA de uso geral, como ChatGPT ou Gemini, é a eficiência de hardware e a escala. Sua arquitetura e seus modelos são desenvolvidos sob medida para vídeo ao vivo, de modo que uma única GPU atende muito mais câmeras do que um modelo de uso geral conseguiria, e a plataforma IREX orquestra centenas de cenários do StreamVLM™ em milhares de câmeras. O StreamVLM™ também roda on-premises, dentro da infraestrutura do próprio cliente: nenhum vídeo nem dado sai do país ou da rede privada.
O problema que o StreamVLM™ resolve
Tradicionalmente, cada novo perigo exigia um novo modelo. Um órgão que quisesse detectar algo não coberto por suas análises precisava reunir milhares de imagens, rotulá-las, treinar um detector e implantá-lo em seus servidores, um ciclo que leva meses a cada solicitação.
Os grandes modelos de visão e linguagem eliminam a etapa de treinamento, pois entendem em palavras o que veem. Mas são lentos: uma única chamada a um VLM leva cerca de 1 a 2 segundos por quadro em uma GPU, enquanto uma rede de câmeras em produção precisa de dezenas de quadros por segundo por GPU em muitos fluxos. Apontar um VLM para todos os quadros de todas as câmeras não é viável.
O StreamVLM™ resolve esse impasse com um funil de dois estágios que gasta GPU só onde importa, alcançando precisão de 97,9 a 100,0% nos oito segmentos de detecção aprovados para produção.
Como funciona o funil de dois estágios
Em uma rede de câmeras real, os incidentes críticos são raros: a grande maioria dos quadros mostra atividade rotineira. O StreamVLM™ coloca um filtro multimodal rápido na frente de um verificador VLM criterioso, de modo que a computação pesada da GPU só é usada quando algo realmente está acontecendo.
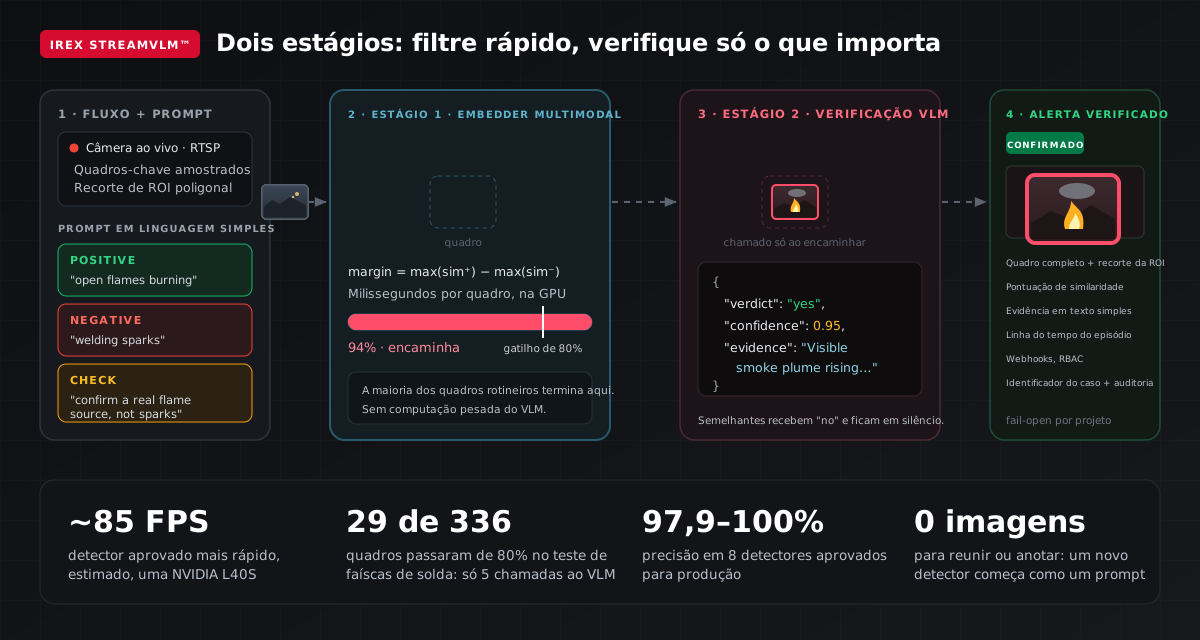
- Estágio 1: embedder multimodal rápido (filtro de margem semântica). A plataforma amostra quadros-chave do fluxo ao vivo, ou de uma região de interesse (ROI) poligonal dentro dele, projeta cada quadro em um espaço de embedding compartilhado de visão e linguagem. Ela compara o quadro com frases-alvo
POSITIVEe frases de falso alarmeNEGATIVEarmazenadas em cache e calcula a margem de similaridade em milissegundos. Quadros rotineiros e semelhanças previsíveis ficam retidos aqui. - Estágio 2: verificação por modelo de visão e linguagem (
CHECK). Somente quando a pontuação do Estágio 1 ultrapassa o gatilho configurado (por exemplo, 80%) e se mantém pelo tempo exigido o StreamVLM™ chama o VLM. Guiado pela instruçãoCHECKdo detector, o VLM inspeciona a cena e devolve um veredito estruturado em JSON (yesouno), uma pontuação de confiança e uma descrição em linguagem simples das evidências que viu.
O efeito é fácil de medir. Em um vídeo de 5 minutos de um pátio industrial amostrado a 1 FPS (336 verificações de quadro), trabalhadores produziram faíscas perto de um braseiro de metal durante quatro minutos. Com “welding sparks at a construction site” (faíscas de solda em um canteiro de obras) definida como âncora negativa, essas faíscas pontuaram entre 55 e 76%, abaixo do gatilho de 80%. Apenas 29 dos 336 quadros ultrapassaram o gatilho. Esses quadros se uniram em apenas 5 chamadas ao VLM no Estágio 2, uma redução de mais de 91% nas invocações do VLM. Quando surgiram chamas reais, o StreamVLM™ confirmou os três episódios de fogo com 95% de confiança.
Prompts em três partes: falsos alarmes eliminados desde o projeto
Os modelos de embedding de texto para imagem lidam mal com a negação. Um prompt com “no smoke” (sem fumaça) ainda corresponde à palavra “smoke” (fumaça). Já um prompt somente positivo para “camels on the road” (camelos na estrada) pode disparar com a passagem de um cavalo, porque os dois animais ficam mais próximos entre si no espaço de embedding do que qualquer um deles do asfalto vazio.
Por isso o StreamVLM™ não depende de uma única frase. Os administradores montam cada detector no Catálogo de Detectores VLM de todo o sistema a partir de três partes:
POSITIVE(1 a 16 frases-alvo): descrições visuais curtas do evento em diferentes condições de iluminação e ângulos de câmera.NEGATIVE(0 a 16 frases de confusão): não eventos conhecidos e semelhanças ópticas que suprimem falsos disparos no Estágio 1.CHECK(regra de verificação do Estágio 2): critérios visuais explícitos que o VLM usa para confirmar o incidente e explicar sua decisão.
Exemplo 1: fumaça de chaminé e fumaça industrial
POSITIVE:
thick black smoke rising from a chimney
dark gray smoke billowing from a rooftop chimney
a plume of smoke coming out of a house chimney
white smoke rising from a residential chimney
a smoking chimney over houses in winter

NEGATIVE:
white steam evaporating from a vent
fog over rooftops in the morning
low clouds over a residential area
a dirty camera lens with smudges
lens flare and sun glare in the sky
a dark tree silhouette against the sky
clear sky over houses with no smoke

CHECK:
Determine whether smoke is actively being emitted from a chimney or flue.
A real chimney smoke plume originates at a chimney mouth, is attached to it,
widens and fades as it rises, and drifts or changes shape across frames.
Distinguish steam, fog or low clouds, lens dirt, glare, and dark static objects.
If smoke is present, classify its color as white, dark, or unknown.
Exemplo 2: fogo aberto versus faíscas de solda
Para detectar queima não autorizada ou um incêndio em estágio inicial em um local industrial sem alarmar por manutenção de rotina, os operadores combinam âncoras positivas de fogo (“open flames burning” (chamas abertas queimando), “a fire with thick smoke” (um fogo com fumaça espessa), “a burning car on fire” (um carro em chamas)) com confusões negativas como reflexo do sol, faróis de veículos, lâmpadas incandescentes e “welding sparks at a construction site”. O Estágio 1 mantém as faíscas abaixo do gatilho; o Estágio 2 confirma o fogo genuíno e escreve uma evidência que o operador lê de relance: “Coluna de fumaça visível subindo de um pequeno fogo em um recipiente de metal, com brasas incandescentes e material em chamas na base.”
A mesma segunda análise compensa nas ruas da cidade. Em testes ao vivo de vários dias em câmeras de vias públicas, monitorando pedestres caídos, veículos de emergência e patinetes ou bicicletas em calçadas, promotores de rua com fantasias de urso de corpo inteiro acionaram repetidamente a similaridade de formato do Estágio 1 com uma pessoa deitada. Todas as vezes, o VLM do Estágio 2 olhou de novo e rejeitou o alarme.
Desempenho aprovado para produção
Cada perfil de detector do StreamVLM™ é validado antes de ser aprovado. O critério de liberação é rigoroso: um detector só é liberado quando atinge pelo menos 97,0% de precisão e pelo menos 90,0% de recall em dados de teste reservados.
Acurácia medida para os oito segmentos de detecção aprovados para produção, com a vazão esperada em uma NVIDIA L40S, a GPU de data center que a IREX opera em sua instalação em Dallas para clientes dos EUA:
| Segmento de detecção | Precisão | Recall | F1 Score | Vazão esperada (1× NVIDIA L40S) |
|---|---|---|---|---|
| Arma no quadro (Detecção de armas) | 98,9% | 95,8% | 0,973 | ~3 FPS |
| Fumaça e fogo (Fogo e fumaça) | 99,2% | 96,1% | 0,976 | ~11 FPS |
| Qualquer fumaça (fogo, chaminé, escapamento) | 98,2% | 94,7% | 0,964 | ~51 FPS |
| Fumaça de fogo perigoso (fogo versus vapor/escapamento) | 97,9% | 92,0% | 0,949 | ~85 FPS |
| Obras viárias e zonas de construção | 97,9% | 97,9% | 0,979 | ~40 FPS |
| Comércio ambulante não autorizado | 100,0% | 97,1% | 0,985 | ~77 FPS |
| Sabotagem de câmera: desfoque | 100,0% | 94,6% | 0,972 | ~15 FPS |
| Animais silvestres / camelos na via | 100,0% | 100,0% | 1,000 | ~5 FPS |
Precisão, recall e F1 são resultados medidos em conjunto de teste no benchmark de validação da IREX. A vazão é uma estimativa de engenharia para uma NVIDIA L40S, escalada a partir de execuções de benchmark pela contagem de núcleos da GPU; um nó de GPU padrão da IREX tem duas. A precisão no mundo real depende do posicionamento das câmeras, da iluminação e da configuração da região de interesse.
A taxa de quadros certa para cada tarefa
Nem toda aplicação precisa olhar cada segundo de vídeo. O StreamVLM™ verifica cada câmera no intervalo que a tarefa exige, e esse intervalo define quantas câmeras uma GPU consegue cobrir:
- Segurança de resposta crítica: para detecção de fogo e fumaça, a IREX recomenda verificar um quadro a cada 10 a 30 segundos para uma resposta rápida.
- Condições de mudança lenta: para monitoramento da lente das câmeras ou controle da limpeza de ruas, o StreamVLM™ pode revisar um quadro a cada 10 a 60 minutos.
Como a vazão é compartilhada entre as câmeras, um intervalo maior multiplica a cobertura. Com um quadro a cada 30 segundos, um detector operando a ~85 FPS poderia, em princípio, cobrir mais de 2.000 canais de câmera em uma única L40S, e com intervalos medidos em minutos a mesma GPU alcança muito mais. É isso que permite ao StreamVLM™ escalar para as milhares de câmeras de uma cidade ou de um estado. O dimensionamento final de cada implantação é feito pela engenharia da IREX.
Criado para controle operacional e governança de IA ética
O StreamVLM™ se integra aos fluxos de trabalho existentes dos centros de comando da IREX:
- Teste de detector em quadro único: antes de um detector entrar em operação, os administradores testam o prompt em um instantâneo de câmera ao vivo ou em uma imagem JPEG ou PNG enviada e veem a pontuação exata de similaridade, o veredito do VLM e sua explicação.
- Vários detectores por câmera: vários detectores StreamVLM™ podem funcionar em um mesmo canal de câmera, cada um com sua própria ROI poligonal. Quando detectores compartilham uma ROI, o Estágio 1 calcula o embedding do quadro uma só vez e o reutiliza em todas as regras ativas. O limite por câmera depende do hardware do cliente e é confirmado durante o piloto.
- Fail-open por projeto: se o serviço de verificação do VLM ficar brevemente indisponível durante um pico de carga, o StreamVLM™ ainda emite o alerta do Estágio 1 e o marca como “Verificação adicional não realizada”, de modo que um incidente de segurança urgente nunca é descartado em silêncio.
- Transparency by Design e responsabilização: cada alerta do StreamVLM™ traz o quadro completo, o recorte da ROI, o percentual de similaridade e a evidência em texto simples do VLM. A busca de eventos exige um identificador do caso. Cada alteração de configuração e cada busca é registrada no registro de auditoria imutável, sob permissões dedicadas de controle de acesso baseado em função (RBAC).
Disponibilidade e roteiro
O alerta em tempo real do StreamVLM™ será entregue no IREX 4.43, com lançamento previsto entre dezembro de 2026 e o início de janeiro de 2027. Ele é executado em um nó de GPU dentro da implantação IREX do cliente, dimensionado pela engenharia da IREX, enquanto o restante da plataforma continua em servidores padrão. A busca retrospectiva em linguagem natural baseada em descritores em arquivos de vídeo armazenados consta do roteiro de produto da IREX para 2027.
Sobre a IREX
A IREX é uma plataforma de IA ética para segurança pública, cidades inteligentes e gestão de tráfego, com mais de 250.000 câmeras implantadas globalmente em 8 países e mais de 100.000 câmeras comprovadas em uma única instância. Construída sobre o princípio de Transparency by Design, a IREX transforma redes de câmeras existentes em ferramentas inteligentes e auditáveis, enquanto os clientes mantêm soberania total sobre seus dados.