 कल्याण
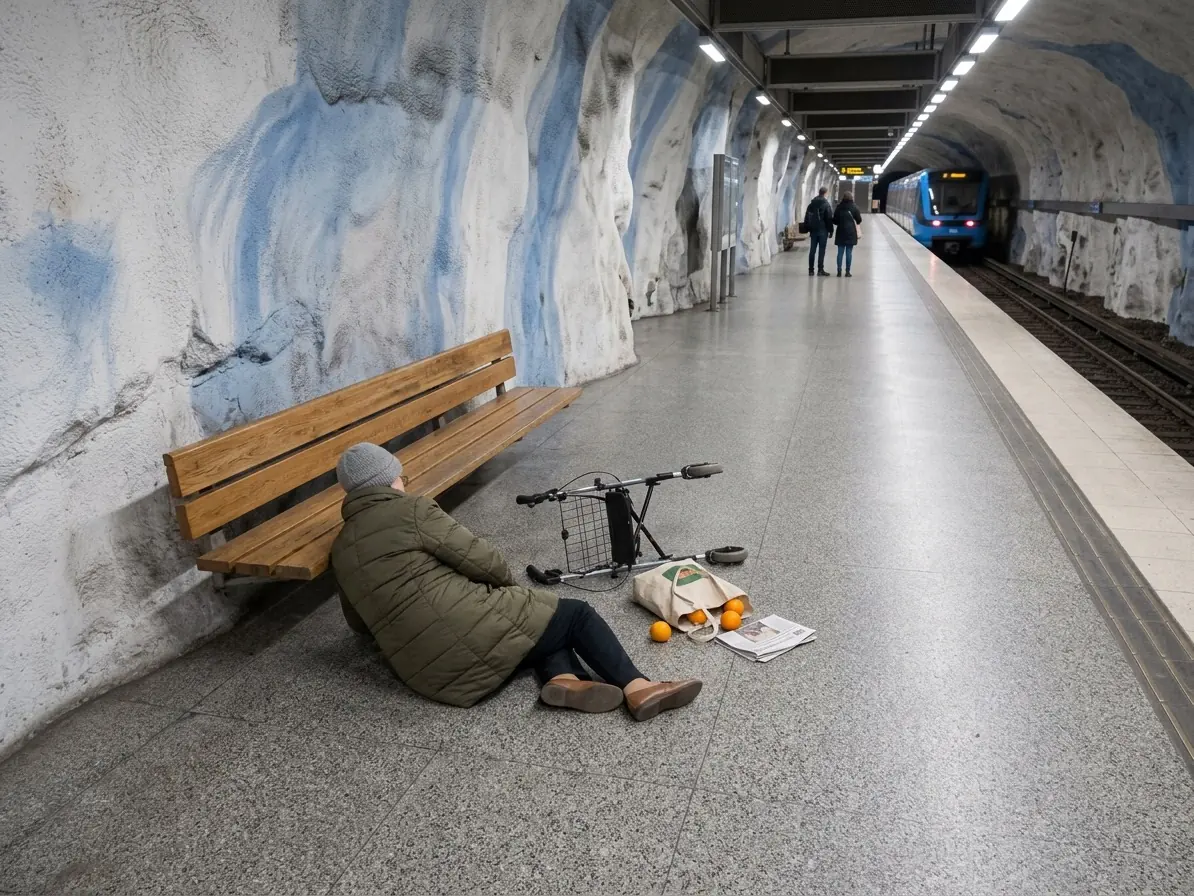
व्यक्ति-गिरना पहचान
ज़मीन पर लेटा हुआ एक व्यक्ति।
और पढ़ें

पारंपरिक वीडियो एनालिटिक्स को हर नए यूज़-केस के लिए महीनों का डेटा-संग्रह, लेबलिंग और ट्रेनिंग चाहिए। StreamVLM™ एक ऐसे Vision-Language Model का उपयोग करता है जो पहले से ही छवियों और भाषा को समझता है, इसलिए जिस डिटेक्टर का वर्णन आप एक वाक्य में करते हैं वह तुरंत काम करना शुरू कर देता है।
लंबी पूँछ
हर शहर के पास ऐसी चीज़ों की एक सूची होती है जिन्हें उसे देखना ज़रूरी है, लेकिन कोई भी एनालिटिक्स वेंडर उनके लिए कोई module नहीं बेचता: ज़मीन पर लेटा कोई व्यक्ति, टूटी हुई बाड़, किसी डिपो के पीछे अवैध कूड़ा-फेंकना। अकेले-अकेले इनमें से कोई भी एक ट्रेनिंग-कार्यक्रम को उचित नहीं ठहराता। साथ मिलकर ये लगभग वही होती हैं जिनकी किसी नगरपालिका को वास्तव में चिंता रहती है, और नीचे दी गई छवि-आधारित लाइब्रेरी ऐसी 24 स्थितियों को कैमरा-दृश्य और हर एक की व्याख्या करने वाले पेज के साथ एक साथ लाती है।
StreamVLM™ यह अंतर पाटता है। ऑपरेटर स्थिति को सरल अंग्रेज़ी में लिखता है, इंजन लाइव कैमरा-फ़्रेम को उस prompt के विरुद्ध जाँचता है, और मैच किसी भी अन्य इवेंट की तरह रियल-टाइम अलर्ट उठाते हैं। हर कैमरा-चैनल एक साथ कई prompt-आधारित डिटेक्टर को सहारा देता है, हर एक का अपना कॉन्फ़िडेंस थ्रेशोल्ड, अलर्ट कूलडाउन, और इवेंट-प्रकार।
StreamVLM™ मानक IREX मूल्य में शामिल है: इसके लिए कोई अलग लाइसेंस, module या सब्सक्रिप्शन शुल्क नहीं है। एकमात्र अतिरिक्त लागत है VLM इन्फरेंस के लिए एक स्थानीय GPU नोड, जहाँ किसी डिप्लॉयमेंट को इसकी ज़रूरत हो।
उदाहरण
"जब कोई व्यक्ति ज़मीन पर लेटा हो तो अलर्ट करें।" प्लेटफ़ॉर्म पर गिरते लोगों का कोई डेटासेट प्रशिक्षण के लिए मौजूद नहीं है, और एक बनाना न तो व्यावहारिक होगा और न ही उचित। किसी Vision-Language Model को इसकी ज़रूरत नहीं: यह दृश्य को पहले से ही समझता है, इसलिए prompt ही विनिर्देश है।

यूज़-केस लाइब्रेरी
24 prompt से परिभाषित स्थितियों को देखें, हर एक के साथ एक उदाहरणात्मक कैमरा-छवि और एक समर्पित पेज। एक संबंधित प्रशिक्षित दोपहिया वर्कफ़्लो इस विज़ुअल लाइब्रेरी को पूरा करता है।
कल्याणज़मीन पर लेटा हुआ एक व्यक्ति।
और पढ़ें →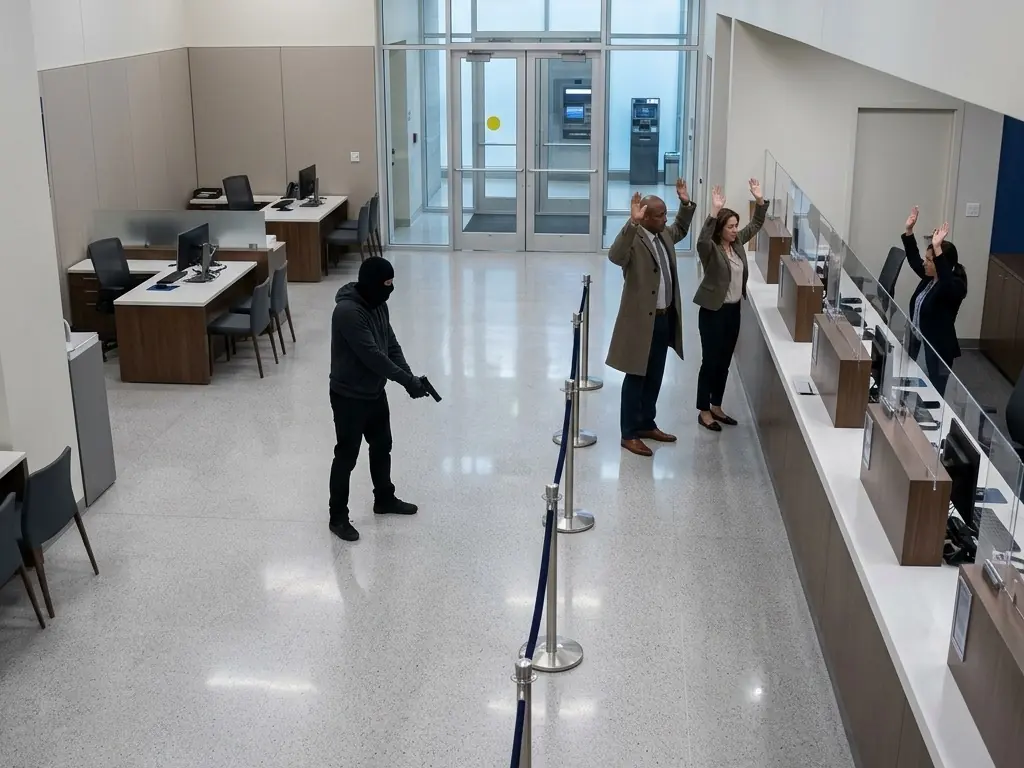 सुरक्षा
किसी संभावित सुरक्षा-घटना के दौरान उठे हुए हाथ।
और पढ़ें →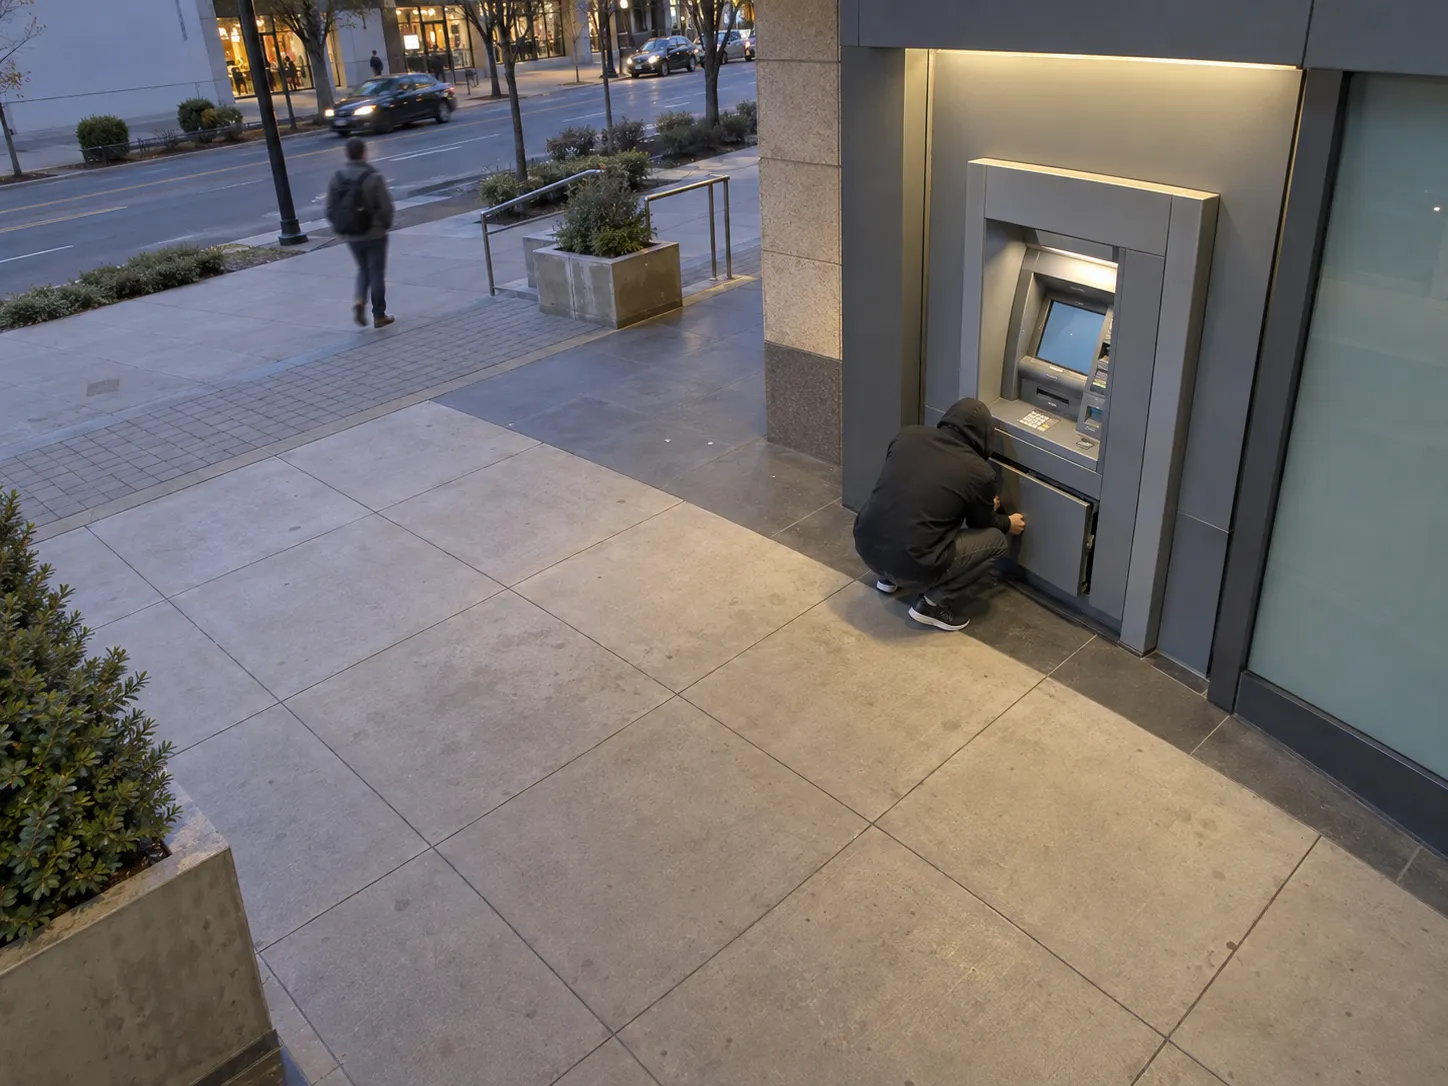 वित्तीय सुरक्षा
दिखाई देती छेड़छाड़ या ख़तरे में मौजूद कोई ग्राहक।
और पढ़ें →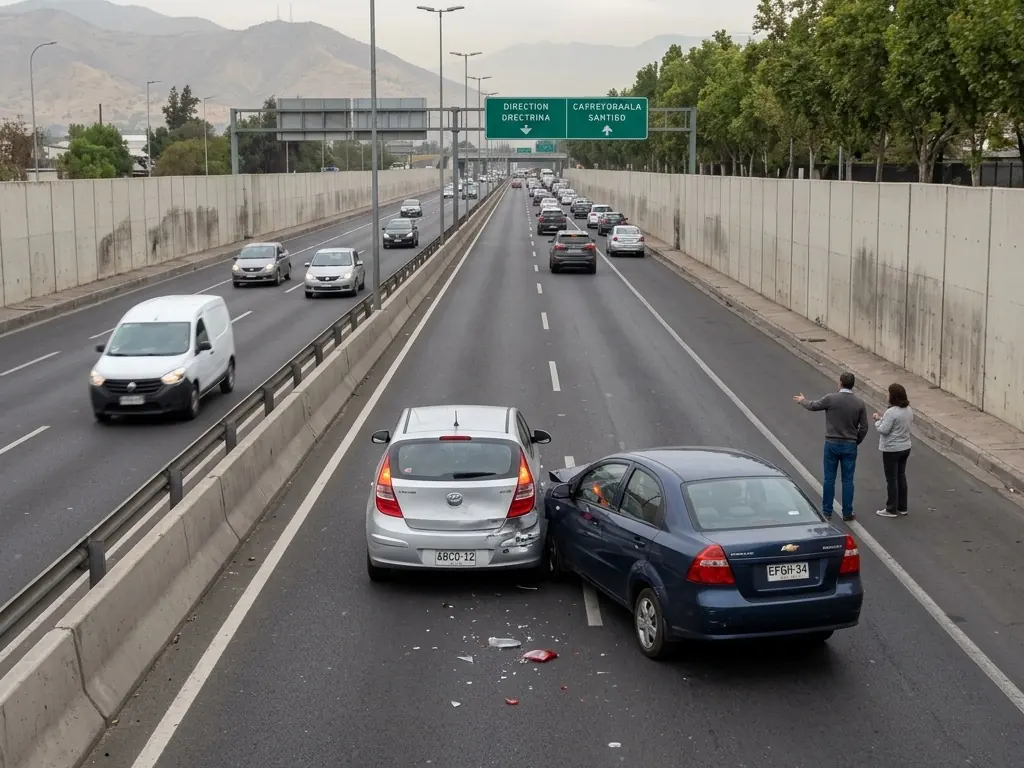 सड़क सुरक्षा
सड़क पर कोई टक्कर या ख़राब खड़ा वाहन।
और पढ़ें →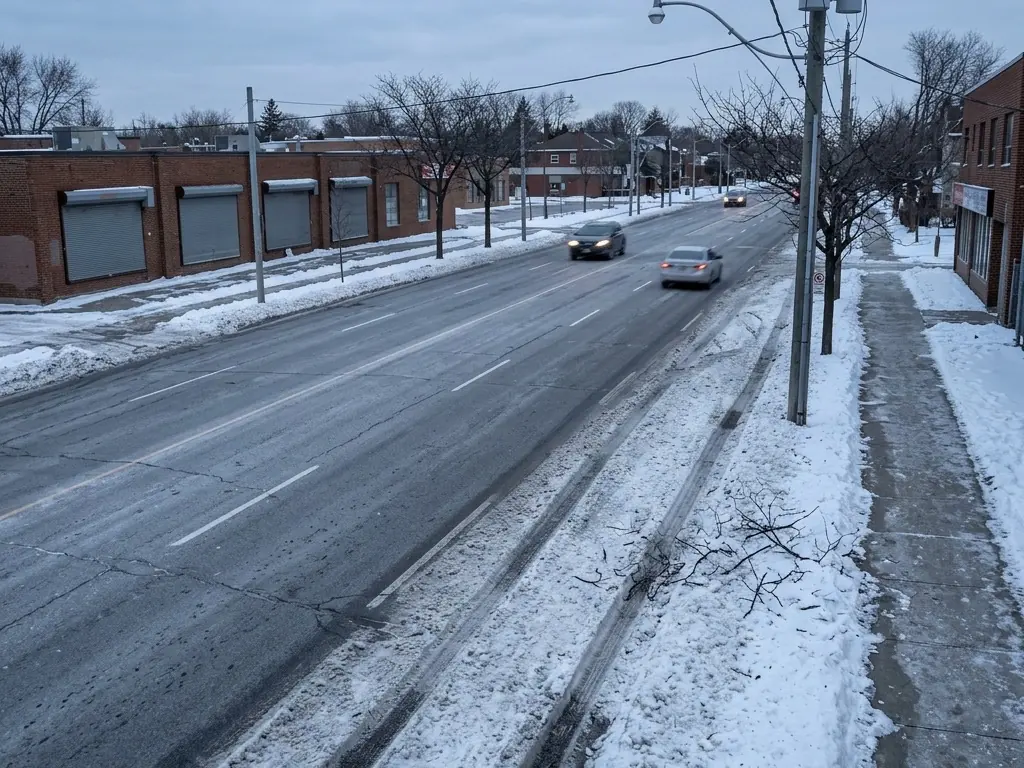 सड़क रखरखाव
किसी लेन या क्रॉसिंग को अवरुद्ध करती वस्तुएँ।
और पढ़ें →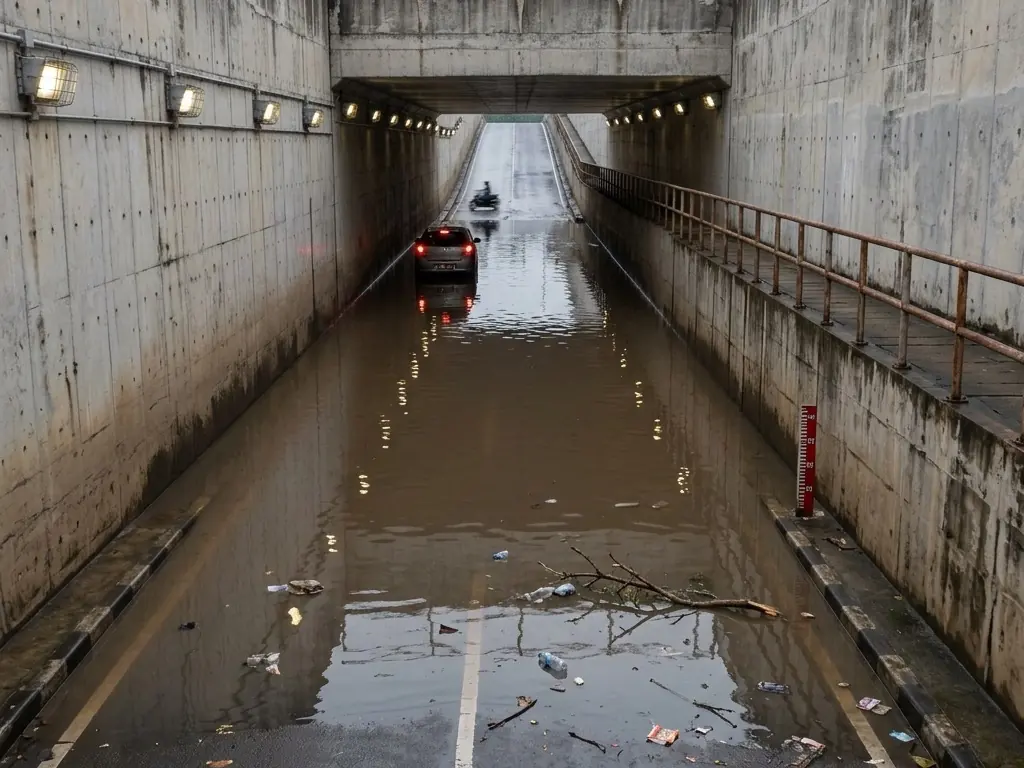 बाढ़
किसी अंडरपास या सड़क में जमा होता पानी।
और पढ़ें →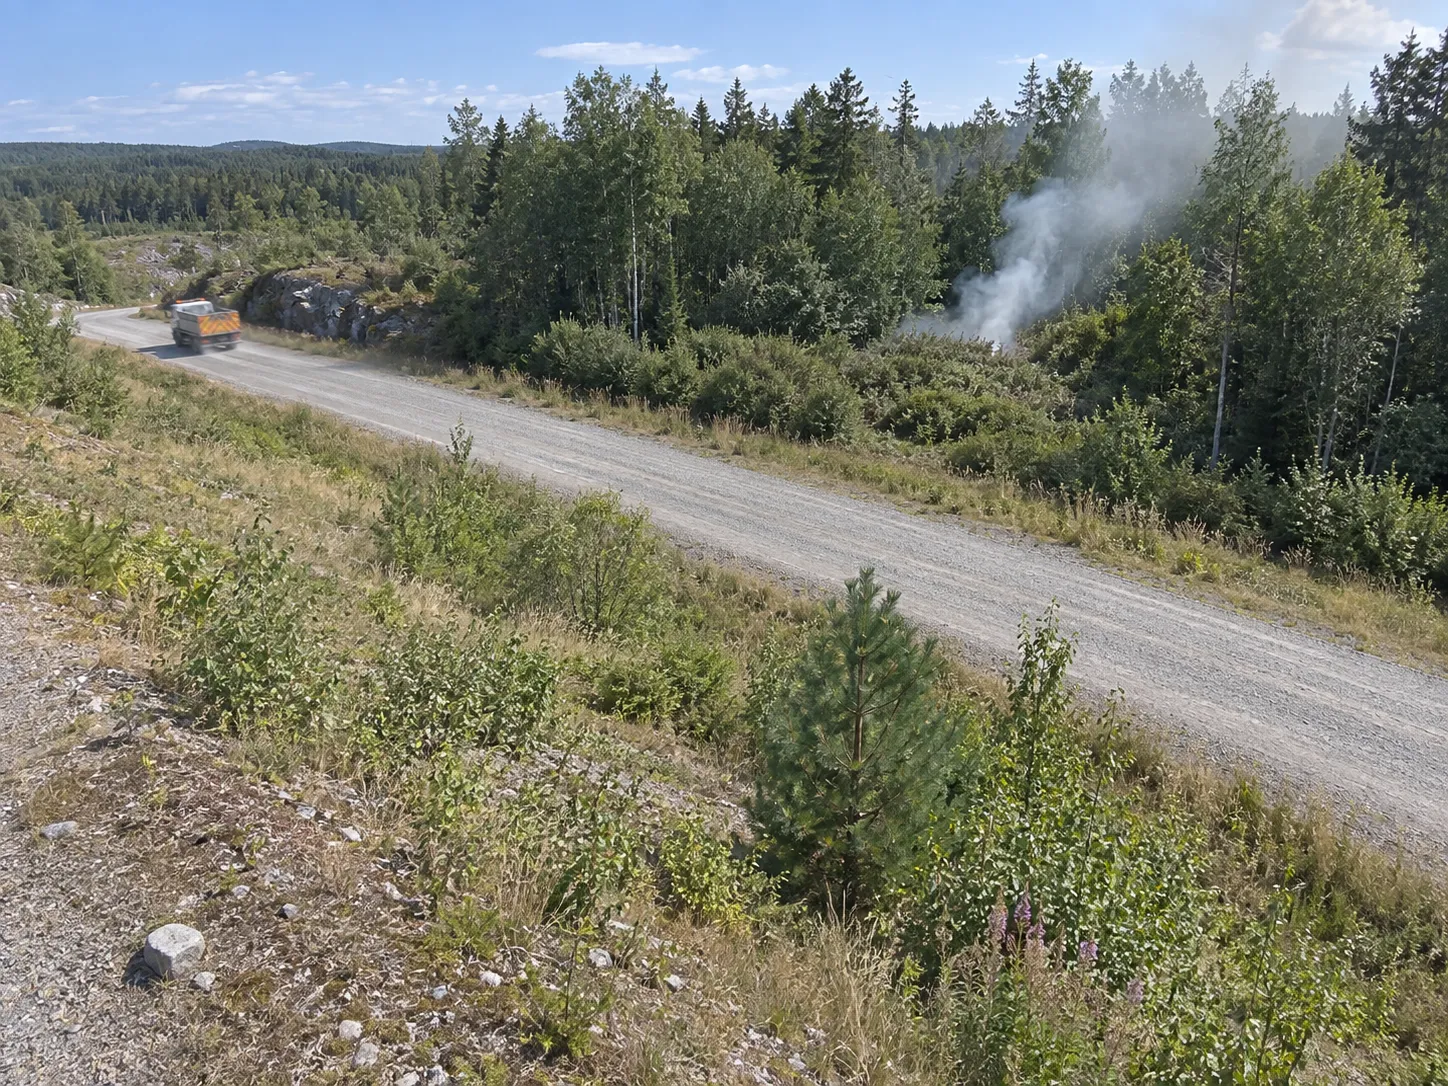 आग और धुआं
खुली ज़मीन के पास दिखाई देता धुआं या आग।
और पढ़ें →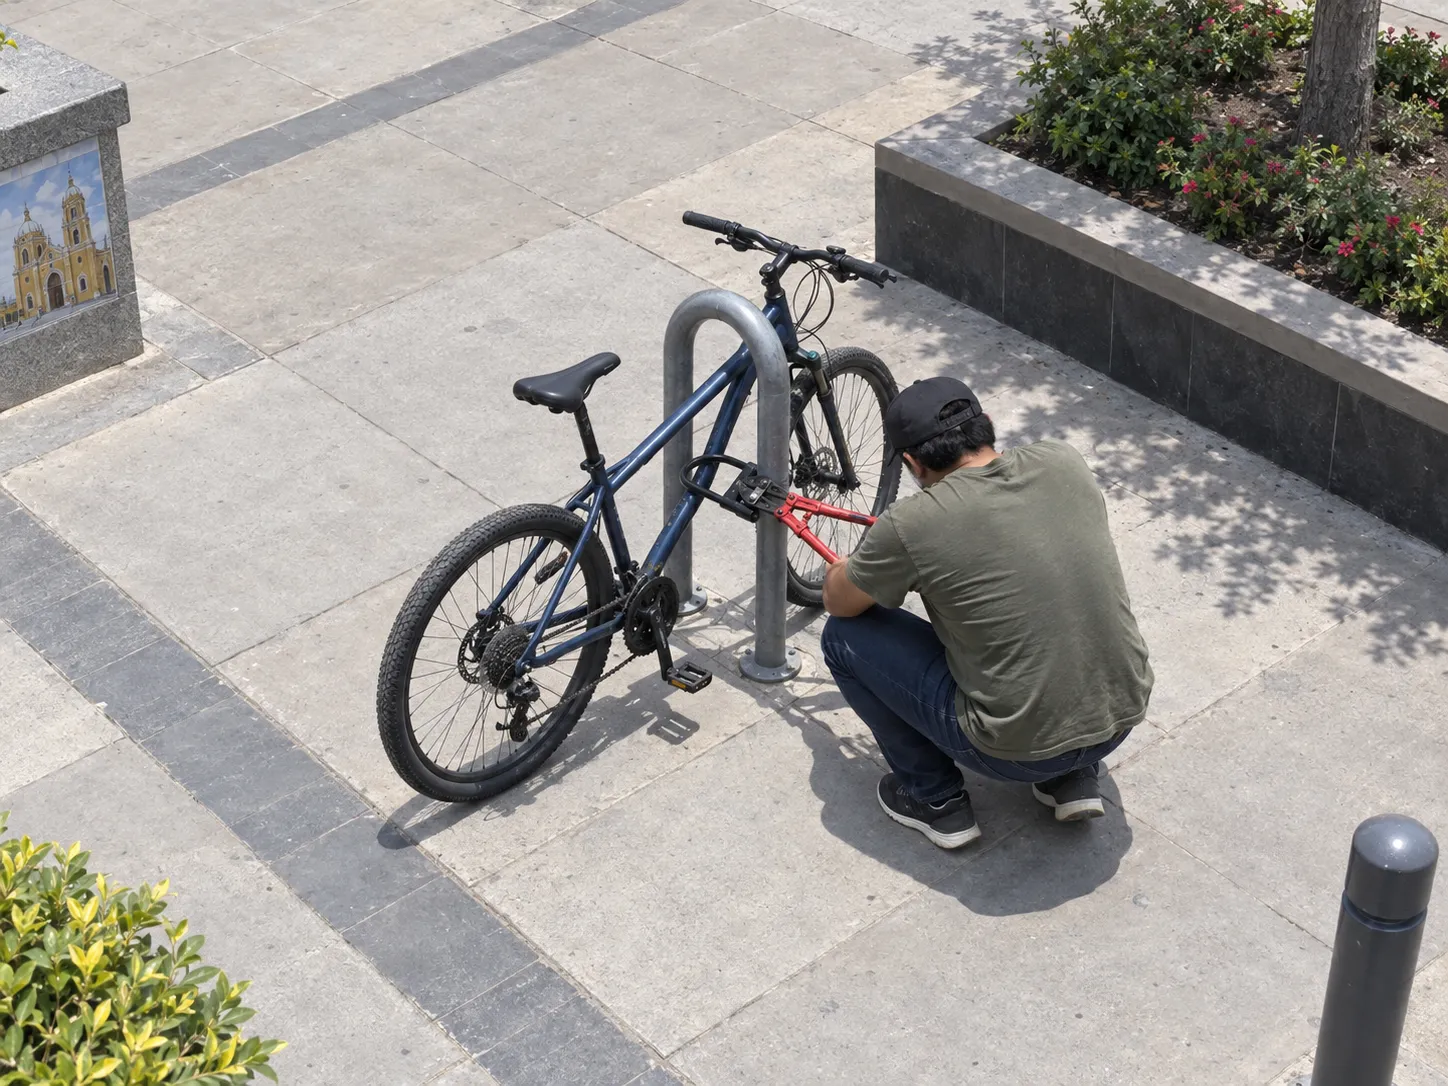 चोरी
किसी साइकिल के ताले को ज़बरन खोलता कोई व्यक्ति।
और पढ़ें →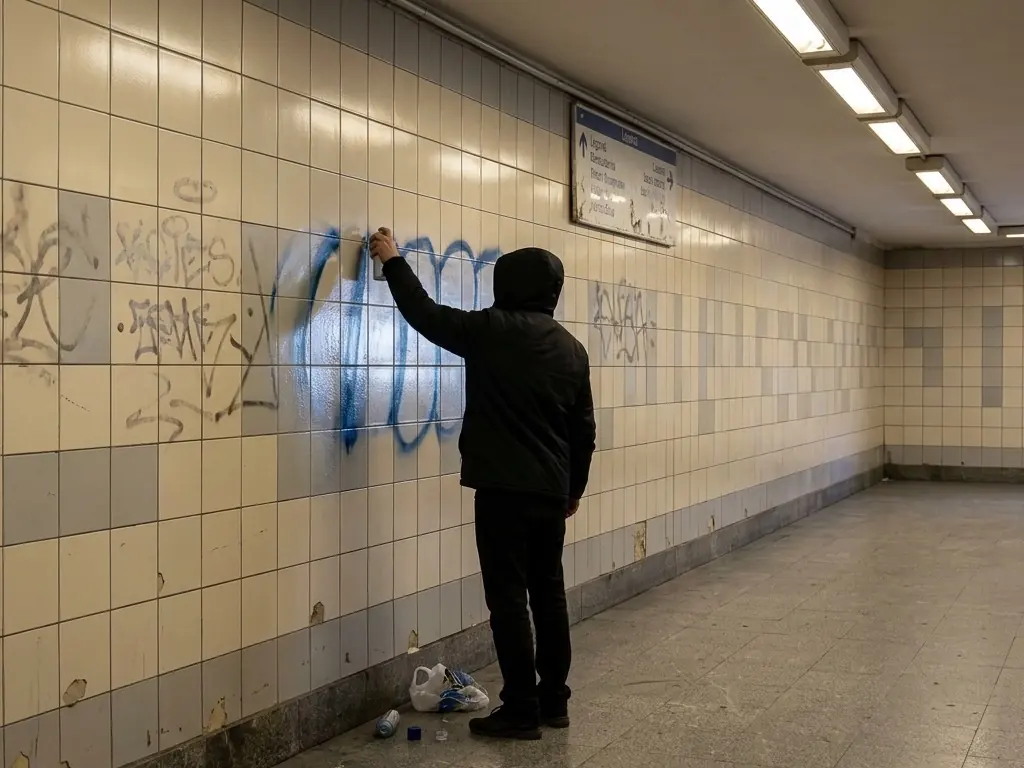 सार्वजनिक स्थान
किसी सतह पर स्प्रे करता या निशान बनाता व्यक्ति।
और पढ़ें →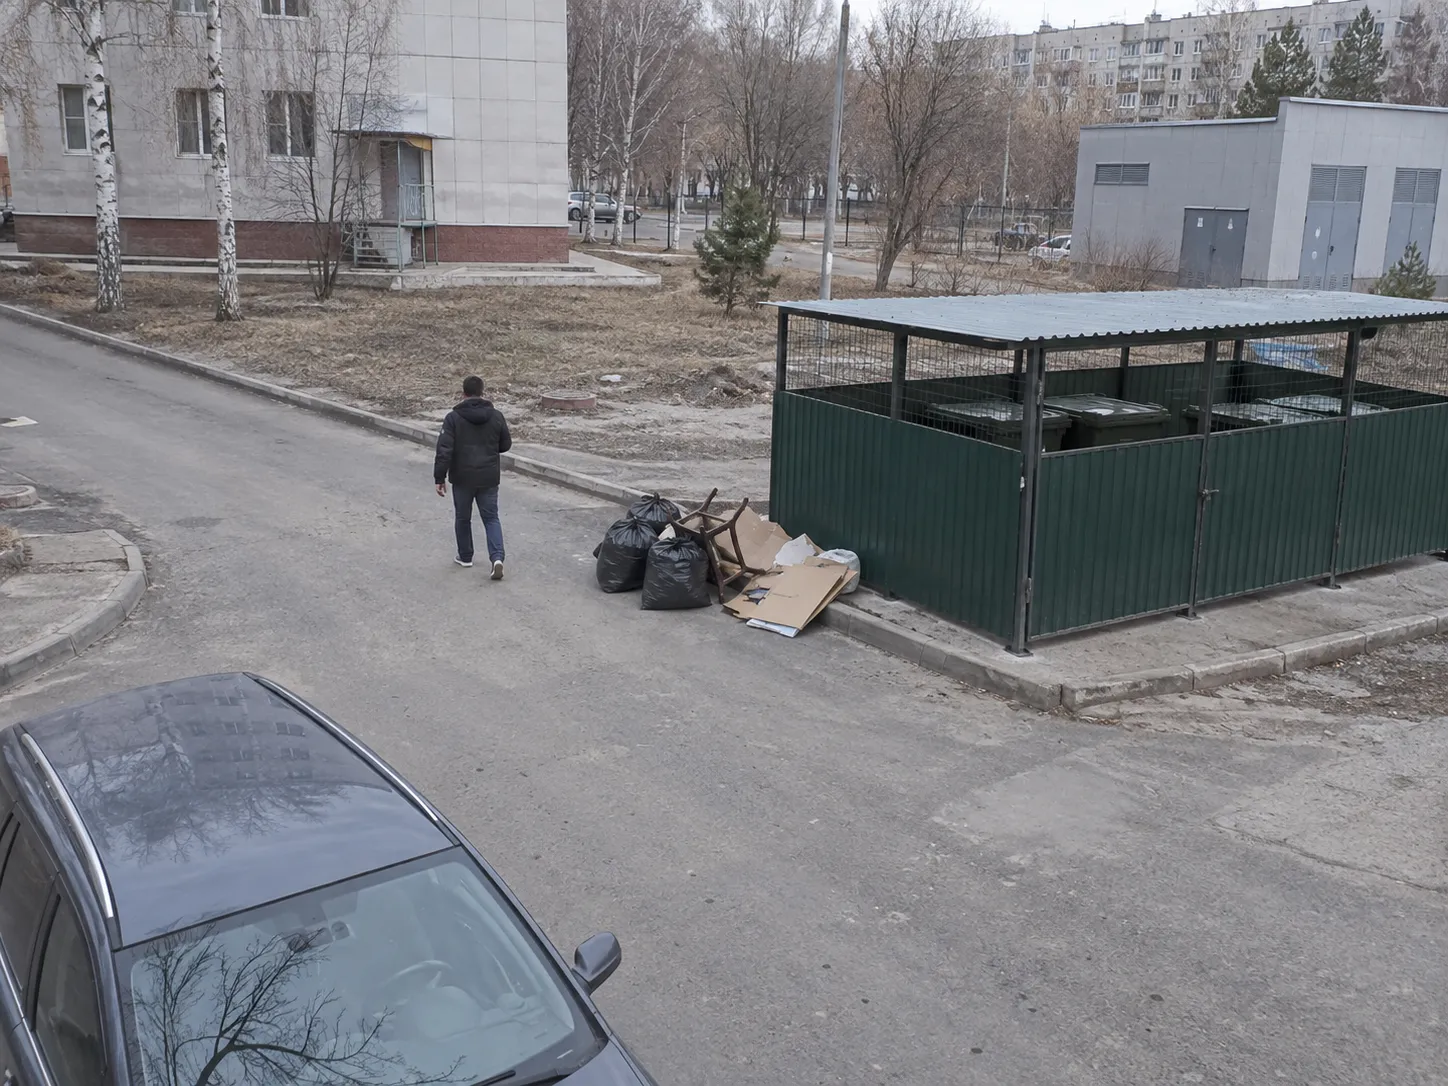 नगरपालिका सेवाएं
निगरानी वाले सार्वजनिक स्थान में छोड़ा गया कूड़ा।
और पढ़ें →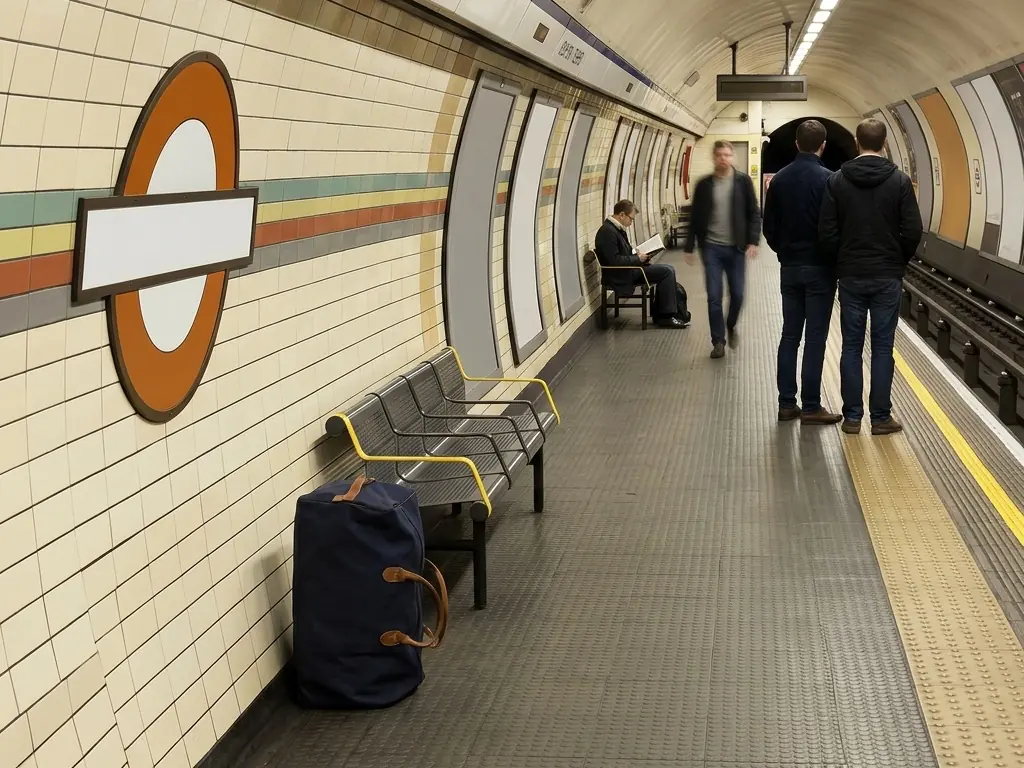 ट्रांज़िट सुरक्षा
अपने मालिक से अलग छोड़ा गया एक बैग।
और पढ़ें →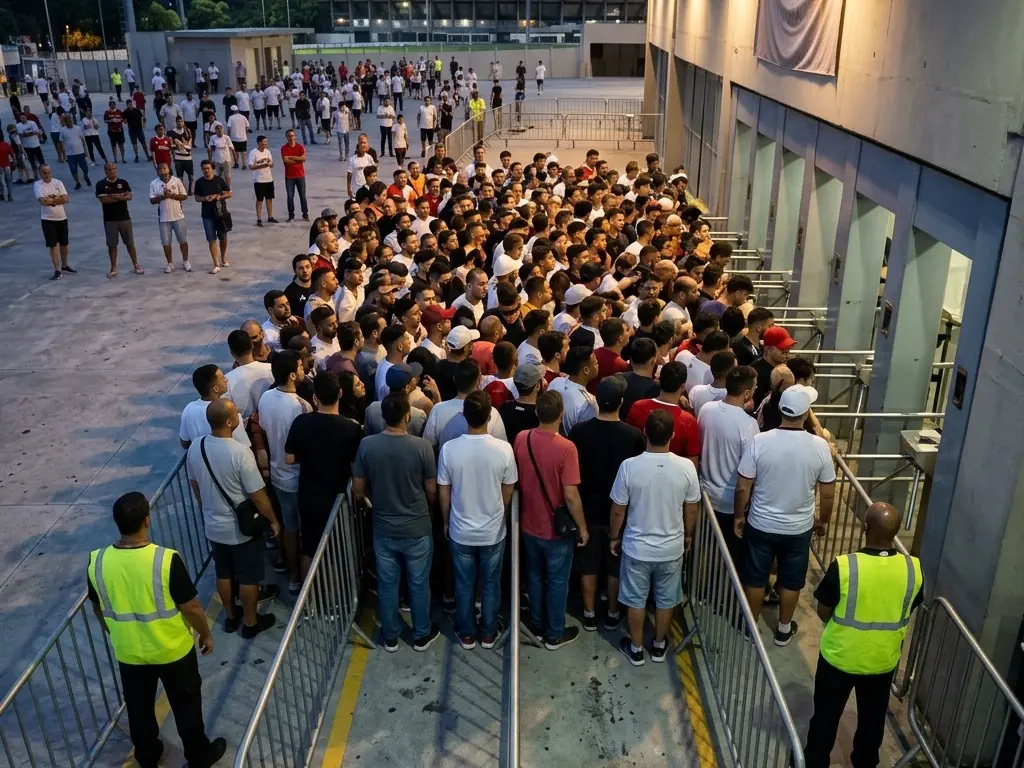 भीड़ सुरक्षा
एक ख़तरनाक घनत्व तक पहुँचती भीड़।
और पढ़ें → क्रॉसिंग सुरक्षा
किसी पैदल-यात्री को रास्ता न देने वाला वाहन।
और पढ़ें → पैदल-यात्री क्षेत्र
 में घुसती एक मोटरबाइक।
और पढ़ें →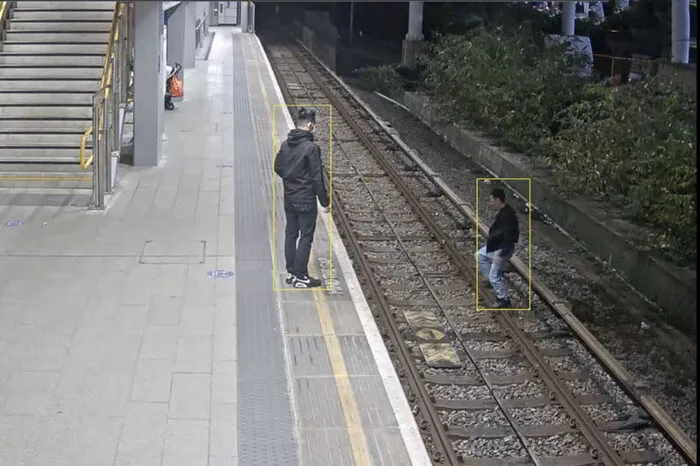 रेल सुरक्षा
ट्रैक-क्षेत्र में घुसता कोई व्यक्ति।
और पढ़ें → सड़क सुरक्षा
ट्रैफ़िक लेन में मवेशी या वन्यजीव।
और पढ़ें → साइट सुरक्षा
काम के घंटों के बाद किसी प्रतिबंधित क्षेत्र में प्रवेश।
और पढ़ें →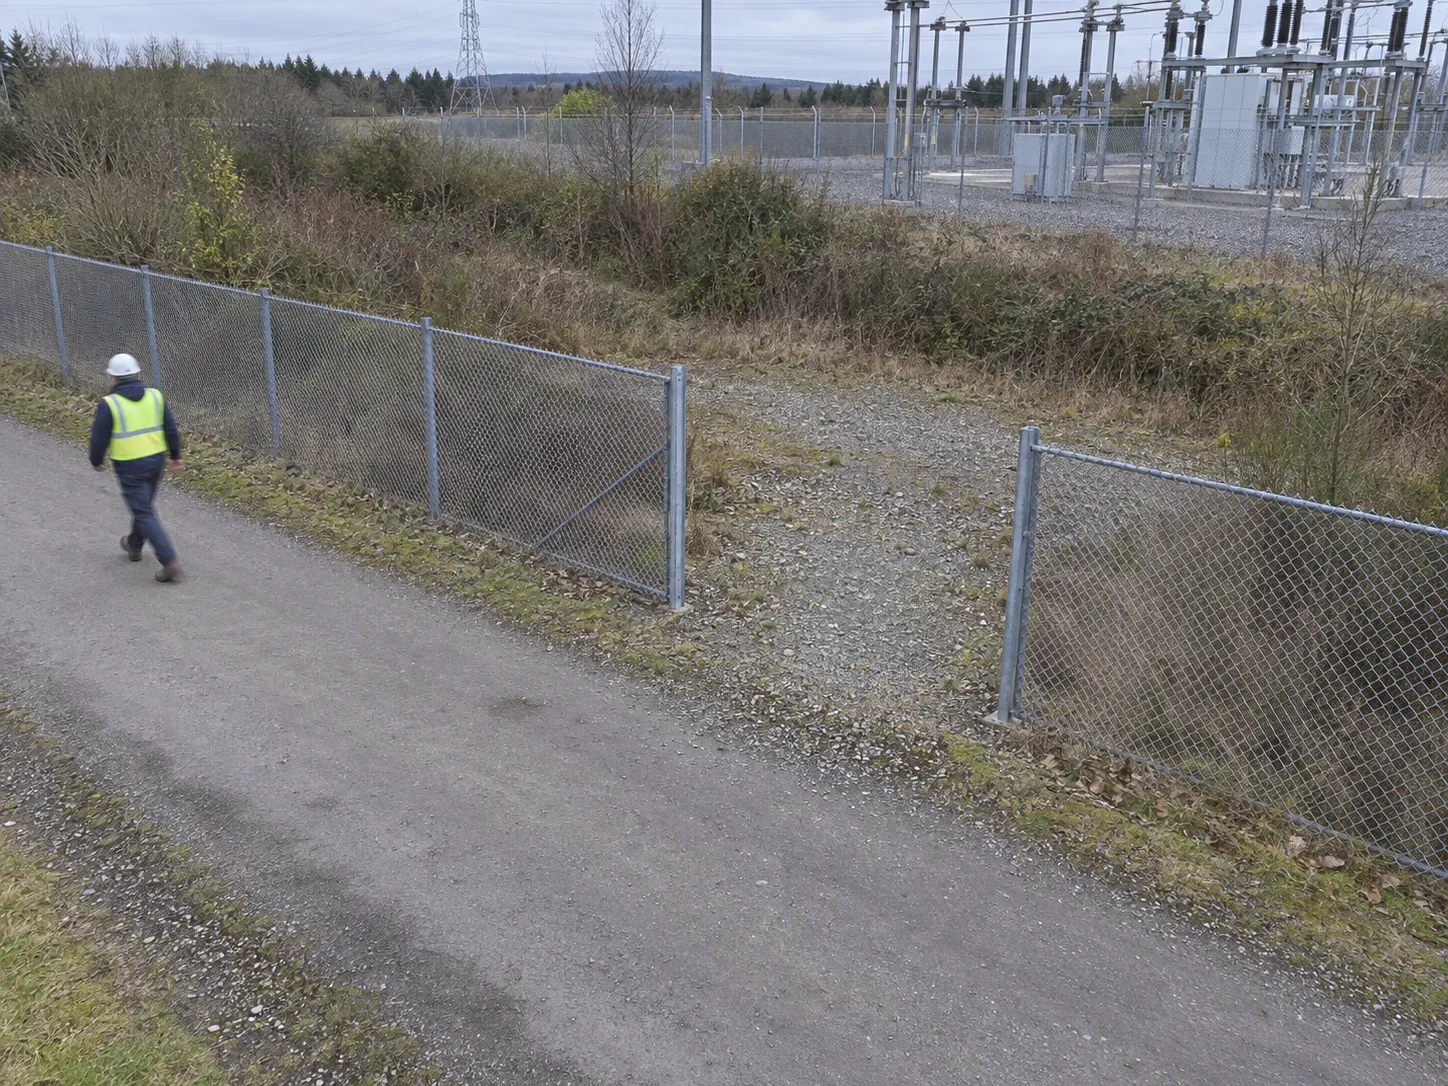 परिधि
सुरक्षा-परिधि का कोई टूटा हुआ हिस्सा।
और पढ़ें → हवाई क्षेत्र
पास में ड्रोन उड़ाता कोई व्यक्ति।
और पढ़ें → सुधार गृह
किसी प्रतिबंधित क्षेत्र में दिखाई देता फ़ोन या टैबलेट।
और पढ़ें →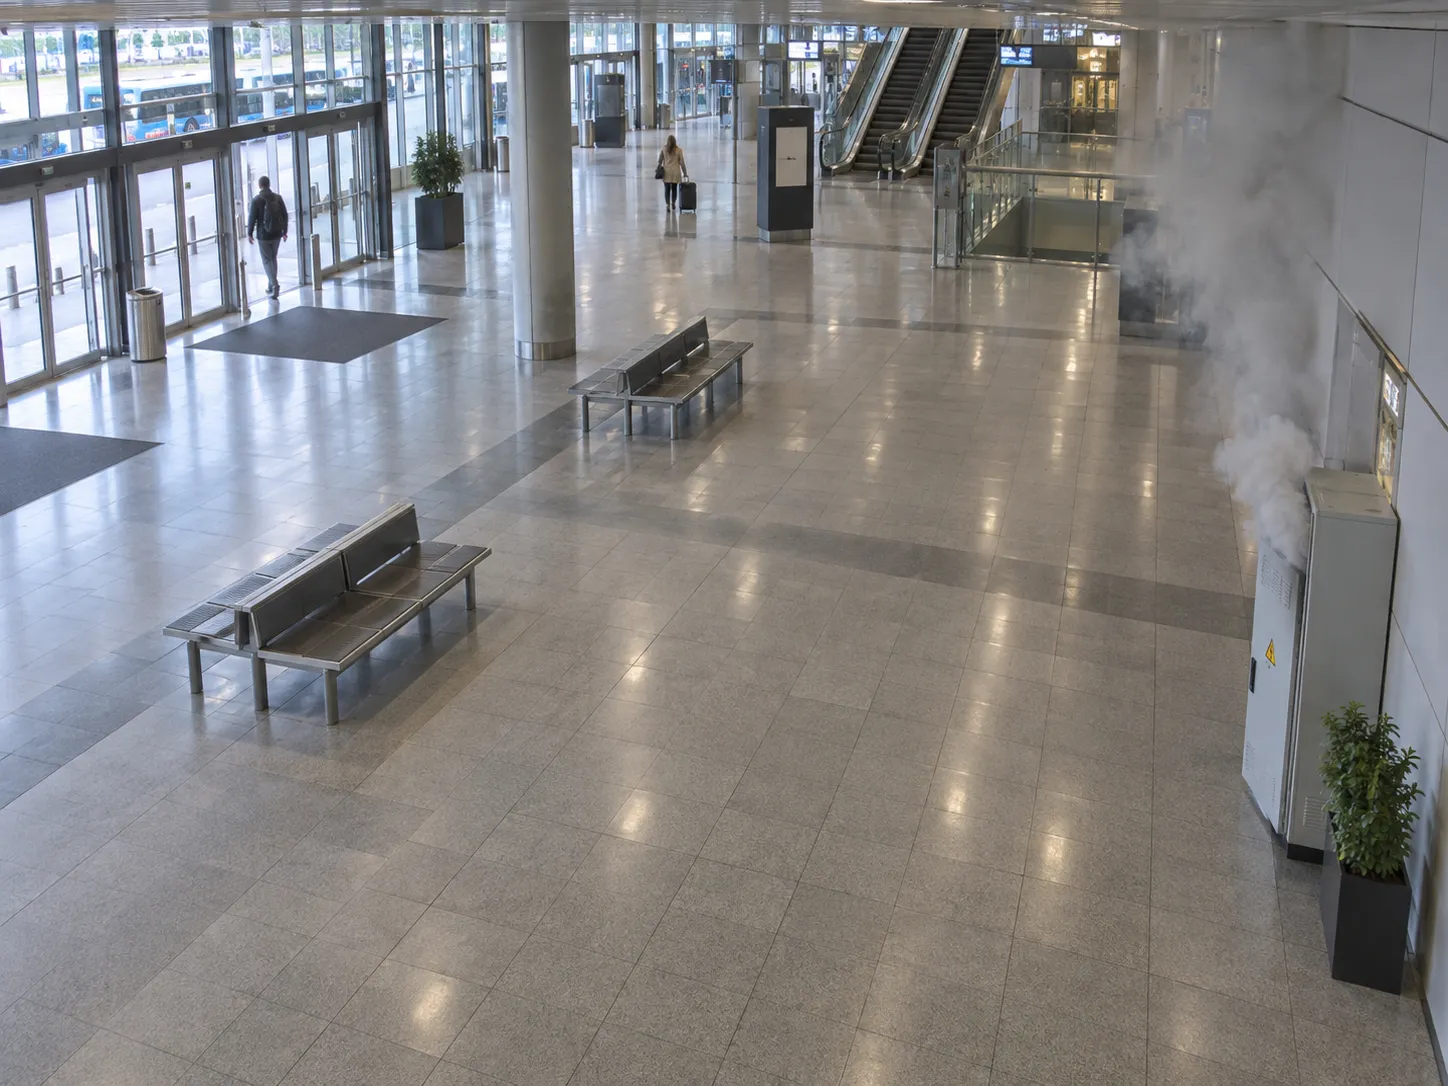 आग और धुआं
किसी टर्मिनल या इमारत के भीतर दिखाई देता धुआं।
और पढ़ें →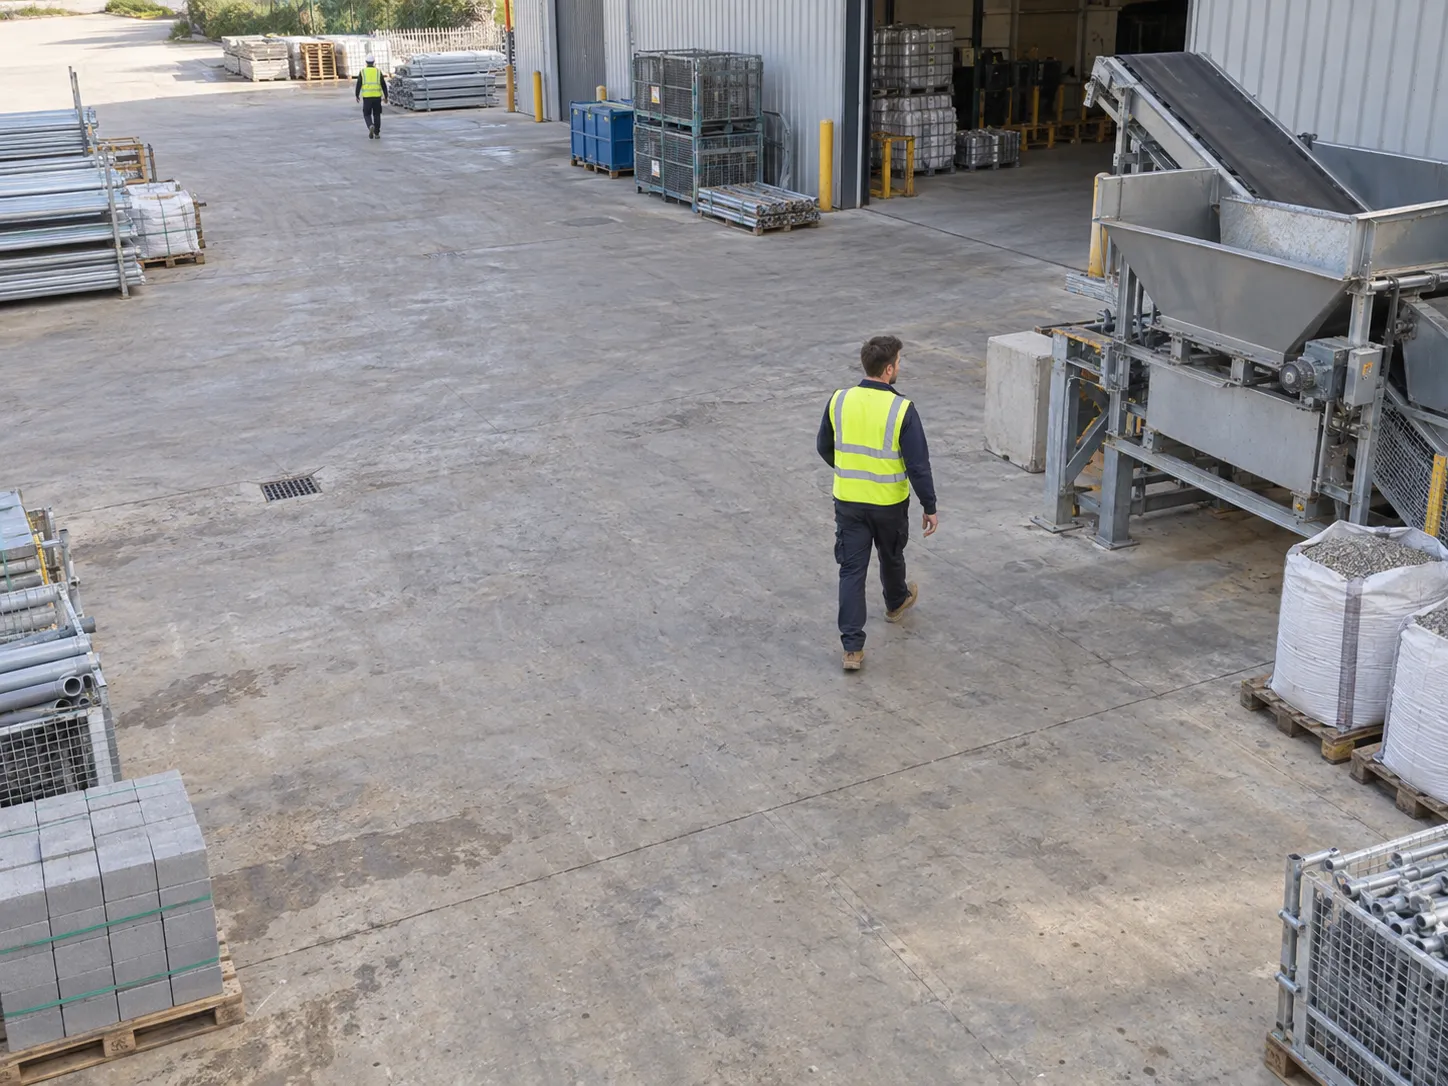 कर्मचारी सुरक्षा
आवश्यक उपकरण के बिना मशीनरी के पास मौजूद कोई कर्मचारी।
और पढ़ें → कैमरा स्वास्थ्य
अवरुद्ध या बिगड़ा हुआ कैमरा-दृश्य।
और पढ़ें → साइट सुरक्षा
ऐसी जगह वाहन जहाँ पहुँच सीमित है।
और पढ़ें → संबंधित प्रशिक्षित module
किसी ATM के पास दो सवारों वाली मोटरसाइकिल। संबंधित प्रशिक्षित module देखें और किसी अधिकारी को क्लिप की समीक्षा करने दें।
और पढ़ें →यह कैसे अलग है
कोई डेटा-संग्रह नहीं, कोई लेबलिंग नहीं, हर यूज़-केस के लिए अलग मॉडल नहीं। एक नया डिटेक्टर बस एक वाक्य है, और यह उसी क्षण से काम करता है जब आप इसे सेव करते हैं।
कई legacy modules को बदलने और एक साथ लाने के लिए डिज़ाइन किया गया, जिनमें आग-पहचान, वीडियो-क्वालिटी मॉनिटरिंग, और टैम्पर-पहचान शामिल हैं।
कॉन्फ़िडेंस थ्रेशोल्ड, अलर्ट कूलडाउन, और इवेंट-प्रकार अलग-अलग सेट किए जाते हैं, ताकि कोई शोर-भरी स्थिति ऑपरेटर को अलर्ट से न भर दे।
हर prompt, विश्लेषित फ़्रेम, अलर्ट, और एजेंट-कार्रवाई को टाइमस्टैंप, ऑपरेटर की पहचान, और Case ID के साथ, भूमिका-आधारित एक्सेस के तहत लॉग किया जाता है।
StreamVLM के इवेंट उन्हीं तीन मोड में प्रवाहित होते हैं जिनमें क्लासिक modules के: रियल-टाइम अलर्ट, आर्काइव पर जाँच, और बिग-डेटा एक्सपोर्ट।
prompt से परिभाषित डिटेक्टर उसी एथिक्स फ़्रेमवर्क के भीतर बैठता है जिसमें प्रशिक्षित modules, जिसमें संकीर्ण-सीमा नियम भी शामिल है।
StreamVLM ग्राहक के instance में GPU नोड पर चलता है। कोई विशिष्ट डिप्लॉयमेंट इसके दायरे में है या नहीं, यह पहले से वादा नहीं किया जाता बल्कि IREX इंजीनियरिंग के साथ पुष्टि की जाती है।
नहीं। StreamVLM मानक IREX मूल्य में शामिल है, बिना किसी अलग लाइसेंस, module या सब्सक्रिप्शन शुल्क के। जहाँ किसी डिप्लॉयमेंट को VLM इन्फरेंस के लिए स्थानीय GPU नोड चाहिए, उस नोड का आकार और मूल्य IREX इंजीनियरिंग के साथ तय होता है।
कई। एक कैमरा-चैनल एक साथ कई prompt से परिभाषित डिटेक्टर ले जाता है, हर एक का अपना कॉन्फ़िडेंस थ्रेशोल्ड, अलर्ट कूलडाउन, और इवेंट-प्रकार। IREX अभी तक कोई प्रति-कैमरा सीमा प्रकाशित नहीं करता: यह सघनता कैसे बढ़ती है यह ग्राहक के हार्डवेयर पर निर्भर करता है, और इसे पायलट के दौरान आपके अपने कैमरों पर मापा जाता है।
यह उनमें से कई को एक साथ लाने के लिए डिज़ाइन किया गया है, जिनमें आग-पहचान, वीडियो-क्वालिटी मॉनिटरिंग, और टैम्पर-पहचान शामिल हैं। प्रशिक्षित हाई-फ़्रेम-रेट डिटेक्टर तेज़ गति से लोगों और वाहनों को ट्रैक करने के लिए अब भी सही उपकरण बने रहते हैं।
किसी तीसरे पक्ष द्वारा प्रकाशित एक ओपन-वेट विज़न-लैंग्वेज मॉडल, और जैसा प्रकाशित हुआ वैसा ही उपयोग किया गया: IREX न तो इसे फ़ाइन-ट्यून करता है और न ही इसके वेट बदलता है, इसे वर्ज़न और चेकसम से पिन करता है, और इसे केवल आपके instance के भीतर, उस instance के अपने GPU नोड पर, नामित एंडपॉइंट पर परोसता है। कोई फ़्रेम, prompt या फ़ैसला instance से बाहर नहीं जाता, और किसी भी क्षेत्र में किसी भी instance पर कोई थर्ड-पार्टी क्लाउड इन्फरेंस उपयोग नहीं होता। मॉडल कोई टूल-कॉल नहीं करता, फ़्रेम के बीच कोई मेमोरी नहीं रखता, इसकी आर्काइव, इवेंट-डेटाबेस, वॉचलिस्ट, अन्य कैमरों या नेटवर्क तक कोई पहुँच नहीं है, और इसमें कोई बायोमेट्रिक फ़ंक्शन नहीं है: यह दृश्यों और स्थितियों का आकलन करता है और किसी व्यक्ति की पहचान नहीं कर सकता। IREX यह प्रकाशित नहीं करता कि यह कौन-सा मॉडल है; इसकी पहचान, वर्ज़न और चेकसम किसी ग्राहक को NDA के तहत बताए जाते हैं, क्योंकि नाम बताया गया मॉडल एक हमला-सतह और एक ऐसा तथ्य है जो पुराना पड़ जाता है। सार्वजनिक AI Model Governance Policy का भाग B यह सब स्पष्ट करता है।
पढ़ते रहें
वे स्थितियाँ लाएँ जिनकी आपके शहर को वास्तव में चिंता है। अगर कोई prompt उसका वर्णन कर सकता है, तो हम आमतौर पर पायलट में आपको उसके लिए एक डिटेक्टर दिखा सकते हैं।